Диагностика для проверки TOAST-сегментов с помощью утилиты toast_recovery_tool
В СУБД Pangolin для хранения данных больших размеров используется механизм TOAST (The Oversized Attribute Storage Technique). TOAST-сегменты представляют собой отдельные таблицы, ссылка на данные которых хранится в основной таблице. Повреждение TOAST-сегментов приводит к потере данных при запросах к таблицам:
ERROR: missing chunk number 0 for toast value 21221812 in pg_toast_16624
Статья описывает работу утилиты toast_recovery_tool — диагностический инструмент на базе Python-скрипта для выявления поврежденных TOAST-сегментов и генерации SQL-скрипта восстановления доступности таблиц. Материал применим при диагностике сбоев, связанных с повреждением TOAST-данных. Восстановление исходных данных утилитой не выполняется.
Утилита позволяет:
- Выявлять поврежденные TOAST-сегменты в базе данных;
- Проверять доступность сегментов по чтению;
- Генерировать SQL-скрипт восстановления доступности таблиц (режим №2);
- Подключаться удаленно без установки утилиты на сервере БД.
Бинарный файл утилиты поставляется в составе серверной части по пути $PHGOME/bin/toast_recovery_tool.
Ограничения
Утилита не выполняет восстановление исходных данных, но в режиме №2 создает SQL-скрипт для восстановления доступности таблицы и выполнения к ней запросов в обычном режиме. Сформированный в результате анализа SQL-скрипт исправления поврежденных данных не запускается автоматически, но может быть применен в ручном режиме администратором СУБД. При этом исходные данные, содержащиеся в полях с признаками внешнего хранения, будут заменены на маркер – «данные повреждены».
Управление
Утилита поддерживает два режима сканирования (scan_mode):
-
Режим №1 – утилита выполняет просмотр диапазонов строк по таблицам для диагностики и локализации проблемного интервала записей с поврежденными данными в полях с признаком хранения TOAST.
Подходит для проверки наличия ошибок в БД в целом. Утилита может запускаться в несколько потоков; если число строк в таблице небольшое, утилита рассчитывает оптимальное число потоков для данного объекта и может запустить только один.
-
Режим №2 – утилита выполняет просмотр диапазонов строк и при обнаружении ошибок в определенном интервале данных автоматически проверяет каждую строку на валидность и генерирует скрипт для фиксирования ошибок (без автоматической корректировки).
В режиме №2 утилита не выполняет автоматическое исправление, но формирует SQL-скрипт для восстановления. Администратор применяет сформированный скрипт в ручном режиме выборочно или полностью. Сгенерированные скрипты подразумевают потерю поврежденных данных в TOAST.
При запуске утилита выполняет первичный анализ списка таблиц, выявляет таблицы с физически существующими TOAST-сегментами и выполняет их проверку.
Список объектов для проверки задается с помощью опции scan_tables_file_name — имя CSV-файла со списком таблиц в формате ['схема','имя таблицы'].
['ext','table1']
['ext','table2']
Опции для запуска утилиты
Список опций утилиты:
| Название параметра | Тип | Значение по умолчанию | Признак | Допустимые значения | Описание |
|---|---|---|---|---|---|
user | string | Отсутствует | Обязательный | Любая строка | Имя пользователя для подключения к БД |
password | string | Отсутствует | Обязательный | Любая строка | Пароль для подключения к БД |
host | string | Отсутствует | Обязательный | IP адрес или имя хоста | Адрес сервера БД |
port | integer | Отсутствует | Обязательный | [1-65535] | Порт подключения к БД |
database | string | Отсутствует | Обязательный | Любая строка | Имя базы данных |
scan_mode | integer | 1 | Обязательный | 1 или 2 | Режим сканирования: №1 - быстрая проверка диапазонов, №2 - проверка строк |
scan_threads | integer | 1 | Опциональный | [1-100] | Количество потоков для сканирования |
scan_all_attributes | boolean | false | Опциональный | true или false | Сканировать все колонки или только первую |
scan_random | boolean | false | Опциональный | true или false | Случайная выборка потоков |
scan_stop_on_first_error | boolean | false | Опциональный | true или false | Остановиться при первой ошибке |
scan_tables_file_name | string | Отсутствует | Опциональный | Имя файла CSV | Файл с таблицами для сканирования |
verbose | boolean | false | Опциональный | true или false | Вывод отладочной информации |
scan_no_index | boolean | false | Опциональный | true или false | Сканировать таблицы без индексов |
scan_depth | integer | 999 | Опциональный | >= 0 | Глубина сканирования |
scan_range | integer | 0 | Опциональный | >= 0 | Размер диапазона сканирования |
scan_latency_mode1 | float | 0 | Опциональный | >= 0 | Задержка в режиме №1 |
scan_latency_mode2 | float | 0 | Опциональный | >= 0 | Задержка в режиме №2 |
scan_notoast | boolean | false | Опциональный | true или false | Сканировать таблицы без TOAST |
Общие опции
scan_mode
1 – проверяется только диапазон записей таблицы (scan_mode=1) без проверки отдельных строк и без создания скрипта исправления.
Подходит для проверки наличия ошибок в базе в целом. Может запускаться в несколько потоков, при этом если число строк в таблице небольшое и с учетом выставленного количества потоков в системе – может например, запуститься только 1 поток, как оптимально вычисленное число для объекта.
2 – проверка отдельных строк (scan_mode=2) с генерацией возможного скрипта ручной коррекции данных строк.
Данные таблиц скрипт не корректирует самостоятельно и не имеет такой опции. При запуске toast_recovery_tool, автоматически формируется список объектов, имеющих TOAST-сегменты и из них выполняется отбор сегментов, имеющих реальные физические сегменты хранения.
scan_all_attributes
Сканирование всех колонок имеющих атрибут хранения TOAST или только первой из списка всех колонок. Сокращает время обработки каждой таблицы.
scan_random
Случайная выборка запускаемого потока. Примерно от 1/3 потоков не запустится.
scan_stop_on_first_error
Остановиться на первой ошибке на таблице и сканировать следующую таблицу в задании (не активируется в режиме scan_range > 0). Включается в режиме №2. Сканирование строк и поиск всех повреждений прекращается после нахождения первой ошибки в данных.
scan_tables_file_name
Список таблиц для задания, опционально. Если не требуется проверить всю БД, а есть только отдельные таблицы для проверки.
verbose
Вывод отладочной информации. Рекомендуется только для поиска проблем в работе опций.
Опции многопоточности
scan_threads
Количество логических одновременных потоков, запускаемых на каждой таблице в задании на сканирование. Список таблиц обходится последовательно. Многопоточности по группам таблиц в этом режиме нет – только многопоточность при обработке каждой таблицы.
scan_depth
Глубина сканирования: число строк, обрабатываемых в одном проходе. При одном потоке задает глубину сканирования всей таблицы, при нескольких — глубину в каждом потоке, поскольку таблица делится на логические партиции по потокам. Не активируется при scan_range > 0.
scan_range
Отменяет параметр scan_depth, если он установлен ранее. Весь объем работы каждого потока или одного потока в зависимости от параметра scan_threads делится на логические части, равные scan_range. Проверка строк выполняется частями длиной scan_range. Используется для оптимизации потребления work_mem. Чем больше потоков, тем меньше размер логических частей и меньше потребление work_mem. Если количество строк < scan_range, будет выполнено сканирование всей таблицы без какого-либо разбиения на логические части в потоках.
Опции управления нагрузкой
scan_latency_mode1
Задержка при работе в режиме №1, применяется при переходе к следующему объекту сканирования. Применяется при планировании ночных заданий или работе на оборудовании с ограниченными ресурсами. Задается в секундах или долях секунды, например 1 (1 секунда) или 0.001 (1 миллисекунда).
scan_latency_mode2
Задержка при работе в режиме №2 (сканирование в режиме tuples), применяется при проходе каждой строки поврежденного интервала данных. Задается в секундах или долях секунды, например 1 (1 секунда) или 0.001 (1 миллисекунда). Если поврежденных интервалов не обнаружено, сканирование отдельных строк не выполняется и задержка не применяется.
scan_notoast
Выполнить сканирование даже если таблица не имеет полей с признаком хранения TOAST или реально не имеющее сегменты хранения этого типа. Этот отдельный режим используется для выравнивания битов подсказки у таблиц. Используется для снижения генерации clog в системах, имеющих преимущественно UPDATE DML-операции, но не выполняющих SELECT.
scan_no_index
Не сканировать таблицу если нет индекса (Primary Key/Unique Key), при значении true запускается сканирование (full scan) без использования индекса. Если параметр не установлен, то проверка таблицы без индекса не выполняется.
Рекомендации
- Перед запуском сканера необходимо выполнить
vacuumпо списку таблиц с обычными настройками. При выключенномvacuumповрежденные данные TOAST могут быть пропущены без вывода предупреждений. - Рекомендуется использовать режим №1 для быстрой диагностики, режим №2 — для детального анализа.
- Рекомендуется использовать параметр
scan_rangeдля оптимизации потребленияwork_memпри работе с большими таблицами. - Требуется создать роль с правами на чтение для подключения к базе данных.
Сценарии использования
Пример запуска утилиты с заполненными опциями:
$ $PHGOME/bin/toast_recovery_tool \
  user:db_user \
  password:"password" \
  host:db_server \
  port:5432 \
  database:test_db \
  scan_mode:2 \
  scan_threads:2 \
  scan_all_attributes:false \
  scan_random:false \
  scan_stop_on_first_error:false \
  scan_tables_file_name:tables.csv \
  verbose:false \
  scan_depth:0 \
  scan_no_index:true \
  scan_range:0 \
  scan_latency_mode1:0 \
  scan_latency_mode2:0.01 \
  scan_notoast:false
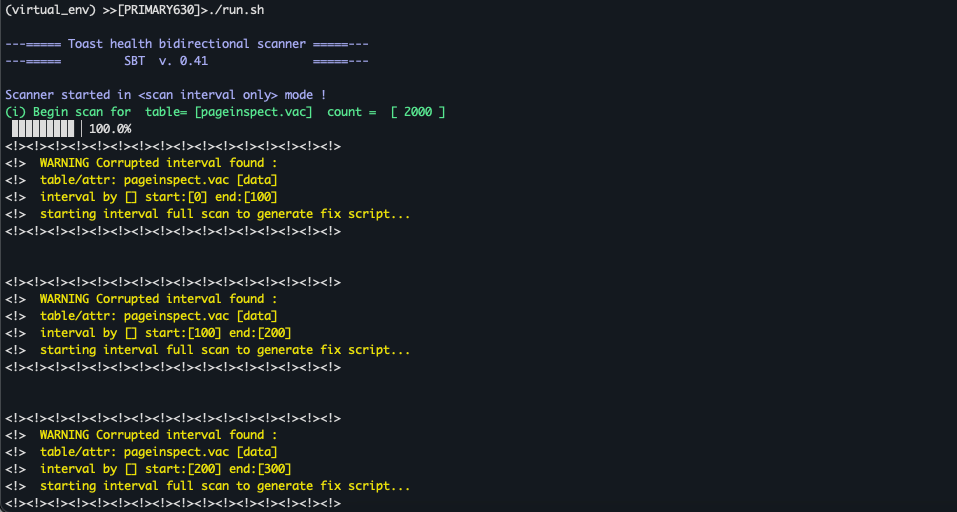
Пример запуска утилиты в режиме №1. Выполняется вывод информации о поврежденных данных и диапазоне, где были обнаружены проблемы:
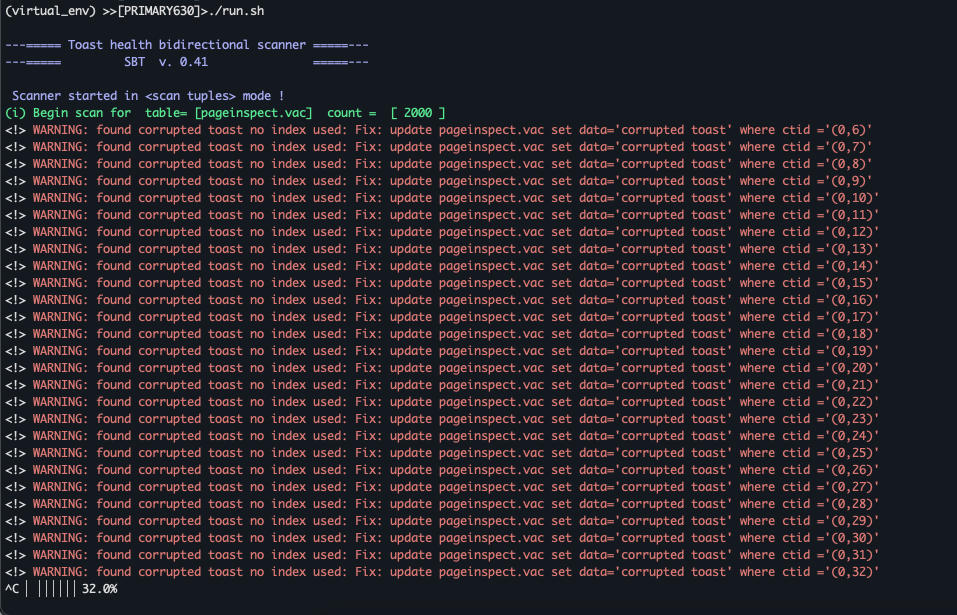
Пример запуска утилиты в режиме №2 (без использования индекса). Выполняется проверка и вывод скрипта для исправления данных: