Уровень 2.0
Предусловие:
- Изучена лекция 5 «Физическое резервное копирование»
В этом задании вы узнаете:
- Общие сведения о физической репликации
- О потоковой репликации
- Как работает репликация с архивом WAL
- Как настроить репликацию
- О переключении на реплику
Физическая репликация
Понятие физической репликации
Алгоритм физического резервного копирования, рассмотренный в предыдущей лекции, опирается на журнал предзаписи (WAL).
В частности, при создании копии, сохраняются записи WAL, необходимые для восстановления консистентности. При этом копирование выполняется либо потоково (с использованием протокола репликации), либо путем непрерывного архивирования.
При восстановлении кластера баз данных скопированные записи WAL применяются процессом startup.
Похожим образом работает и физическая репликация: журнальные записи, генерируемые одним экземпляром сервера, непрерывно передаются и применяются на другом экземпляре сервера. Процесс startup при этом работает постоянно, восстанавливая данные из получаемых журнальных записей.
Таким образом происходит синхронизация кластеров баз данных двух или более экземпляров в режиме реального времени (или близкого к реальному времени).
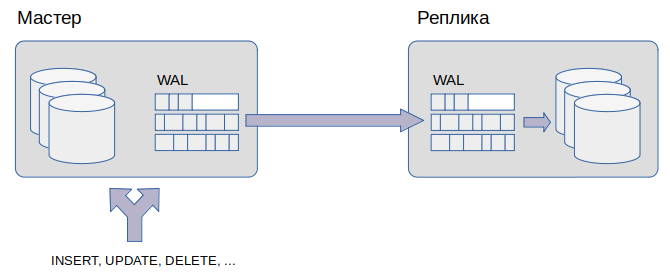
При этом экземпляр сервера, формирующий записи WAL, называется мастером (или ведущим сервером, primary), а экземпляр сервера, принимающий и применяющий записи WAL, — репликой (или ведомым сервером, standby).
Так как журнал предзаписи является общим для всех баз данных кластера, то реплицировать можно только весь кластер без возможности выбора баз данных или объектов в них.
Записи WAL при этом применяются репликой без понимания семантики выполненных изменений. За счет этого обеспечивается высокая скорость репликации, однако, как и при физическом резервном копировании, требуется двоичная совместимость серверов — экземпляры мастера и реплики должны быть развернуты на совместимых платформах и иметь одну и ту же основную версию Pangolin.
Доставка записей WAL также может быть обеспечена двумя способами:
- Потоково — с использованием протокола репликации
- Путем непрерывного архивирования
Поскольку реплика является полной копией мастера, на ней недопустимы операции изменения данных и, следовательно, не могут формироваться новые записи WAL. На реплике лишь проигрываются записи WAL, получаемые от мастера. Запросы на чтение при этом на реплике выполняться могут.
Назначение физической репликации
Физическая репликация может использоваться для:
- Обеспечения отказоустойчивости
- Повышения производительности
Во-первых, физическая репликация позволяет повысить степень отказоустойчивости. Реплика в этом случае используется в качестве резервного сервера: при выходе из строя мастера обслуживание клиентов может быть переключено на реплику. Для этого предусмотрена возможность повышения статуса реплики до мастера.
Во-вторых, физическая репликация может использоваться для повышения производительности информационной системы за счет горизонтального масштабирования вычислительных ресурсов — нагрузка распределяется на несколько серверов. Нагрузка в этом случае распределяется путем перенаправления запросов клиентов на различные экземпляры серверов. Для этого используется балансировщик нагрузки, примером которого является HAProxy.
При этом экземпляры серверов могут быть настроены под различные типы нагрузки. Например, один экземпляр — под OLTP-нагрузку, другой — под OLAP.
Ограничения репликации
Как вы уже знаете, на реплике не могут выполняться никакие изменения данных, а именно:
- Команды DML (
INSERT,UPDATE,DELETE,TRUNCATE, ...) - Блокировки, используемые для изменения данных (
SELECT FOR UPDATE,SELECT FOR NO KEY UPDATE, ...) - Команды DDL (
CREATE,DROP,ALTER, ...) - Команды управления доступом (
GRANT,REVOKE, ...) - Команды обслуживания (
VACUUM,REINDEX,CLUSTER, ...)
Кроме того, на реплике не поддерживается уровень изоляции транзакций SERIALIZABLE, а также рекомендательные блокировки.
Также на реплике не срабатывают триггеры, поскольку они выполняются на мастере и их результаты доставляются на реплику в журнальных записях.
Команды создания табличных пространств (CREATE TABLESPACE), выполняемые на мастере, доставляются и выполняются на реплике. Однако необходимо иметь в виду, что у пользователя, от имени которого запущен Pangolin, могут отсутствовать необходимые права для создания каталогов для табличных пространств.
Потоковая репликация
Схема работы
При потоковой репликации записи WAL доставляются с использованием протокола репликации.
За отправку записей WAL на мастере отвечает процесс wal sender, а за их получение на реплике — wal receiver.
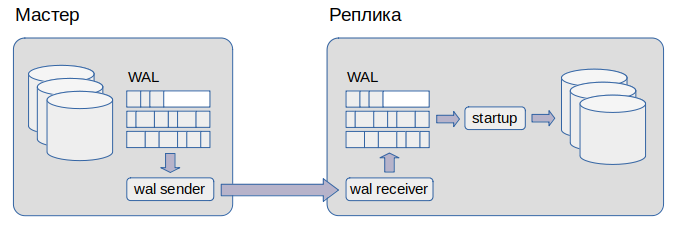
Получаемые процессом wal receiver записи WAL сначала сохраняются в сегменты WAL, а затем проигрываются процессом startup.
Потоковая репликация позволяет минимизировать отставание реплики от мастера.
Для гарантии сохранности еще неполученных репликой записей на мастере используется слот репликации. Однако при этом необходимо выполнять мониторинг его использования. Иначе, если реплика по каким-либо причинам перестанет получать журнальные записи, количество файлов-сегментов WAL на мастере начнет увеличиваться, что может привести к переполнению дискового пространства.
Мониторинг
В процессе потоковой репликации на различных этапах трансляции записей WAL возможно возникновение задержек.
В Pangolin предусмотрено несколько точек мониторинга процесса трансляции журнальных записей:
- Сохранение сформированной на мастере журнальной записи в сегменте WAL
- Трансляция журнальной записи процессом
wal sender, возможно с использованием слота репликации - Получение записи на реплике процессом
wal receiver - Сохранение записи на реплике процессом
wal receiverна накопителе - Применение записи на реплике процессом
startup
Для каждой из указанных точек можно отследить позицию текущей журнальной записи, транслируемой через нее. Помимо этого, могут быть получены временные задержки на различных этапах трансляции.
При этом для мониторинга не обязательно обращаться к реплике — вся информация может быть получена на мастере, поскольку реплика передает состояние репликации при каждой записи на накопители, но не реже чем раз в wal_receiver_status_interval секунд (по умолчанию 10).
Позицию записи на мастере (первая точка мониторинга) можно получить функцией pg_current_wal_lsn.
Состояние остальных точек мониторинга определяется с использованием представления pg_stat_replication, а именно из следующих полей:
sent_lsn— позиция последней записи, переданной процессомwal senderwrite_lsn— позиция последней записи, полученной процессомwal receiverflush_lsn— позиция последней записи, сброшенной на накопитель процессомwal receiverreplay_lsn— позиция последней записи, примененной процессомstartupwrite_lag— задержка получения записи процессомwal receiverс момента ее сохранения в сегменте на мастереflush_lag— задержка сброса на накопитель записи процессомwal receiverс момента ее сохранения в сегменте на мастереreplay_lag— задержка применения записи процессомstartupс момента ее сохранения в сегменте на мастере
При использовании слота репликации информацию о его состоянии можно получить с использованием представления pg_replication_slots.
При необходимости информацию о состоянии репликации можно получить также на реплике. Для этого используются представление pg_stat_wal_receiver, а также функции pg_stat_wal_receive_lsn и pg_stat_wal_replay_lsn.
Репликация с архивом WAL
Схема работы
При настроенном непрерывном архивировании в качестве источника журнальных записей для реплики также может выступать архив.
В этом случае сформированные на мастере файлы-сегменты WAL копируются в архив процессом archiver путем выполнения команды оболочки, указанной в параметре archive_command (подробнее в задании «Протокол репликации и архив WAL»). В свою очередь, на реплике процесс startup получает сегменты из архива путем выполнения команды оболочки, указанной в параметре restore_command.
Вспомним, что записи WAL сохраняются в файлы-сегменты, размер каждого из которых ограничен 16 Мб. В процессе непрерывного архивирования копирование файла-сегмента WAL командой
archive_commandвыполняется только после его полного заполнения.
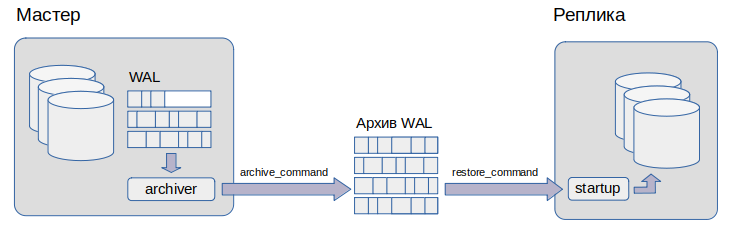
При этом архив может использоваться либо в качестве единственного источника сегментов WAL для реплики, либо в дополнение к настроенной потоковой репликации.
Во втором случае если реплика не сможет получить очередную журнальную запись по протоколу репликации, например из-за потери соединения с мастером, она предпримет попытку получить ее из архива.
После восстановления соединения реплика автоматически переключится в режим получения журнальных записей по протоколу репликации.
В этом случае можно отказаться от использования слота репликации, поскольку гарантия сохранности записей WAL обеспечивается архивом.
Необходимо учитывать, что при использовании архива в качестве единственного источника записей WAL реплика будет отставать от мастера на время заполнения сегмента. Помимо этого, мастер в этом случае не знает о существовании реплики, что, как будет показано ниже, иногда ограничивает решение определенных проблем.
Очистка архива
Если архив используется только для синхронизации данных на одной реплике, то можно настроить автоматическую очистку.
Для этого на реплике необходимо в параметре archive_cleanup_command указать команду оболочки, которая будет выполняться процессом checkpointer по окончании каждой точки перезапуска.
Точка перезапуска — это процедура, выполняемая на реплике, аналогичная процедуре контрольной точки, выполняемой на мастере.
Дело в том, что применение на реплике записей WAL выполняется посредством кеша буферов. Страницы, сформированные из записей WAL и попавшие в кеш буферов, являются грязными пока не будут сброшены на накопители. Пока такие страницы не сброшены сегменты WAL, содержащие соответствующие им записи, не могут быть удалены, поскольку необходимы для восстановления в случае сбоя.
Поэтому для предотвращения увеличения количества сегментов WAL требуется периодическое выполнение сброса грязных страниц из кеша буферов на накопители. Такая процедура сброса называется точкой перезапуска и выполняется процессом checkpointer. После ее завершения ставшие ненужными сегменты WAL удаляются процессом checkpointer с использованием команды archive_cleanup_command.
Для автоматической очистки архива в команде archive_cleanup_command часто используется утилита pg_archivecleanup.
Настройка репликации
Подготовка и запуск репликации
Для создания реплики требуется физическая копия кластера баз данных.
В каталоге данных при этом должен находиться пустой файл standby.signal. Он нужен, чтобы процесс startup понимал, что не должен прекращать свою работу после восстановления согласованности (или, по-другому, что экземпляр является репликой).
Помимо этого, тем или иным способом должна быть настроена доставка записей WAL с мастера.
В случае использования архива на мастере должно быть настроено непрерывное архивирование, а на реплике задан параметр restore_command.
Однако использование архива в механизме репликации, как правило, является дополнительным способом доставки журнальных записей, в то время как основным способом является потоковый, с использованием протокола репликации.
Для настройки потоковой репликации в копии кластера должны быть заданы параметры подключения к экземпляру мастера. Для этого предусмотрен конфигурационный параметр primary_conninfo, в котором указывается строка подключения.
Вспомните, что для использования протокола репликации уровень журнала (
wal_level) должен быть не нижеreplica, значение параметраmax_wal_sendersдолжно быть достаточным, а в файлеpg_hba.confдолжны быть указаны разрешения подключения к виртуальной базе данныхreplication(см. лекцию «Протокол репликации и архив WAL»).
Также на мастере или в архиве должно быть обеспечено наличие записей WAL с момента создания копии. LSN этого момента указан в параметре START WAL LOCATION в файле backup_label, который создается в каталоге данных при резервном копировании.
На мастере это может быть обеспечено путем создания слота репликации перед резервным копированием и сохранением его как минимум до того момента, как реплика догонит мастер по записям WAL после запуска.
При использовании слота репликации он должен быть указан в копии на реплике в параметре primary_slot_name.
Подготовка кластера баз данных для использования в качестве реплики может выполнена с использованием утилиты pg_basebackup, например:
pg_basebackup -h 172.29.53.4 -U replicator -D /pgdata/\{major-minor\}.0/data -R -S replication_slot
В этом случае в качестве параметров pg_basebackup указаны:
-h— хост мастера-U— роль для подключения к экземпляру сервера на мастере-D— каталог для сохранения копии-R— указание о создании файлаstandby.signalи задание значений для параметровprimary_conninfoиprimary_slot_name-S— имя слота репликации на мастере
Также подготовить кластер баз данных можно с использованием утилиты pg_probackup. Это делается командой pg_probackup restore аналогичными ключами -R и -S. Однако в случае pg_probackup копия должна быть заранее создана.
Подготовленный таким образом экземпляр может быть запущен в качестве реплики командой pg_ctl start.
При этом по умолчанию реплика будет работать в режиме горячего резерва, то есть сможет принимать запросы от клиентов на чтение. Однако выполнение запросов можно запретить путем установки параметра hot_standby=off.
Режимы репликации
Из курса DBA2 (тема «Журнал предзаписи») известно, что фиксация транзакций может осуществляться в двух режимах: синхронном и асинхронном.
За режим фиксации транзакций отвечает параметр synchronous_commit (по умолчанию on).
В синхронном режиме команда фиксации транзакции возвращает управление только после сохранения соответствующих журнальных записей на накопителях, а в асинхронном режиме команда фиксации немедленно возвращает управление, а журнальные записи сохраняются в фоновом режиме. При асинхронном режиме часть данных может быть потеряна в случае сбоя, поскольку в момент сбоя соответствующие журнальные записи могут еще находиться в кеше WAL в оперативной памяти.
Физическая репликация позволяет повысить надежность сохранения изменений при фиксации транзакции. Если не завершать фиксацию до подтверждения репликой получения соответствующей записи WAL, то данные не будут потеряны даже при выходе из строя накопителя на мастере.
При значении параметра syncronouse_commit=on на мастере фиксация транзакции завершается только после попадания соответствующей журнальной записи на накопитель реплики.
Данные в этом случае не могут быть потеряны, однако нет гарантии того, что они будут видны при выполнении запроса на реплике, поскольку соответствующие журнальные записи могут быть еще не проиграны процессом startup.
Это поведение можно изменить путем установки syncronous_commit=remote_apply. В этом случае фиксация транзакции будет завершаться только после применения соответствующей записи на реплике. Конечно, использование такого режима негативно сказывается на скорости фиксации транзакций.
И наконец, опишем самый «легкий» режим подтверждения фиксации транзакции на реплике.
При значении параметра syncronous_commit=remote_write реплика отправляет подтверждение мастеру сразу при получении соответствующей журнальной записи. Фиксация транзакции на мастере завершается.
В случае сбоя на реплике часть данных, не записанных на накопитель, может быть потеряна.
Для того чтобы отключить синхронную фиксацию транзакций на реплике, но сохранить на мастере, необходимо использовать значение syncronous_commit=local.
При использовании синхронной репликации ведомые серверы должны быть указаны в параметре synchronous_standby_names.
При использовании нескольких реплик может быть настроена фиксация транзакций на основе получения подтверждений только от части ведомых серверов. Для этого перед списком имен реплики указывается конструкция FIRST n или ANY n. В первом случае достаточно получения подтверждения от первых n реплик из списка, во втором — от любых n реплик из списка.
Конфликты мастера и реплики
Если на реплике допускается выполнение запросов (hot_standby=on), возможна ситуация, при которой мастер выполнит действие, несовместимое с запросом на реплике.
К таким действиям относятся:
- Очистка мертвых версий строк, которые используются в снимке данных на реплике
- Наложение исключительной блокировки на объект, используемый в запросе на реплике
Мониторинг таких ситуаций может осуществляться с использованием представления pg_stat_database_conflicts.
Частично эту проблему можно решить, избегая конфликтующих действий на мастере.
В том числе не выполнять команды, накладывающие исключительные блокировки (TRUNCATE, DROP TABLE и т. д.), и не использовать функциональность, неявно накладывающую исключительные блокировки (например, отключить усечение файлов при выполнении очистки — vacuum_truncate=off).
В общем случае эту проблему можно решить путем откладывания применения на реплике записей WAL, содержащих несовместимые с выполняемыми запросами действия.
Для этого используются следующие параметры:
max_standby_streaming_delay— задержка применения несовместимой журнальной записи при потоковой репликации (по умолчанию 30 секунд)max_standby_archive_delay— задержка применения несовместимой журнальной записи при использовании архива (по умолчанию 30 секунд)
Если к моменту истечения времени задержки конфликтующий запрос не успеет выполниться, то он будет прерван.
Помимо этого, для потоковой репликации может быть настроена обратная связь реплики с мастером. Это позволит передавать мастеру текущий для реплики горизонт очистки. Таким образом, мастер, имея информацию о еще нужных реплике версиях строк, не будет их очищать.
За настройку обратной связи на реплике отвечает параметр hot_standby_feedback (по умолчанию off).
При включенной обратной связи текущий горизонт очистки реплики можно получить на мастере с использованием представления pg_stat_replication (поле backend_xmin) или, при использовании слота репликации, с использованием представления pg_replication_slots (поле xmin).
Необходимо иметь ввиду, что при использовании слота репликации совместно с режимом обратной связи слот (даже неактивный) будет задерживать не только очистку сегментов WAL, но и очистку мертвых версий строк, что может привести к разрастанию файлов данных.
Переключение на реплику
В случае использования реплики в качестве резерва (горячего или теплого) рано или поздно возникнет необходимость переключения обслуживания клиентов на нее путем повышения статуса до мастера.
Переключение на реплику может быть плановым, например для выполнения технического обслуживания мастера, и незапланированным, например при возникновении сбоя на мастере.
В первом случае (switchover) переход на реплику может быть спланирован в удобное время.
Во втором случае (failover) переход на реплику должен быть выполнен быстро, с минимизацией времени простоя системы (Recovery Time Objective, RTO).
Так или иначе перед переходом на реплику важно убедиться, что мастер действительно остановлен. Иначе данные на мастере и на реплике могут разойтись, и их склейка будет непростой задачей, а в некоторых случаях невыполнимой.
Способы переключения на реплику
Повышение статуса реплики может выполняться в ручном или автоматическом режиме.
Для реализации автоматического режима требуются сторонние средства, такие как Pangolin Manager, которое будет рассмотрено в лекции «Обеспечение высокой доступности».
В ручном режиме повышение статуса реплики до мастера может быть выполнено следующими способами:
- Командой оболочки
pg_ctl promote - Вызовом SQL-функции
pg_promote - Указанием имени файла в параметре
promote_trigger_file(переключение происходит при появлении файла с указанным именем)
Также можно удалить файл standby.signal в каталоге данных реплики и перезапустить ее. Однако в таком случае реплика не будет знать, что процесс восстановления завершен, и не перейдет на новую линию времени.
Возвращение мастера
После успешного переключения обслуживания клиентов на бывшую реплику, бывший мастер может быть подключен уже в качестве реплики (конечно, если отключение не было связано с его выходом из строя).
Если при этом бывший мастер был остановлен аккуратно, с выполнением контрольной точки, и все сгенерированные им журнальные записи успели дойти до бывшей реплики, то его можно подключить к новому мастеру в качестве реплики, установив соответствующие конфигурационные параметры.
Однако если бывший мастер был остановлен в результате сбоя (или в режиме immediate), так просто подключить его в качестве реплики не получится, поскольку часть сгенерированных им журнальных записей, скорее всего, не успела дойти до бывшей реплики.
В этом случае возможно два варианта.
Во-первых, можно заново создать базовую резервную копию с нового мастера и использовать ее для настройки новой реплики. Это надежный, но, возможно, неприемлемо долгий способ возвращения бывшего мастера в строй в качестве реплики.
Во-вторых, можно использовать утилиту pg_rewind, которая находит место расхождения журнальных записей двух экземпляров, определяет общую для них ближайшую контрольную точку и заменяет страницы данных на новой реплике измененными на новом мастере с момента указанной контрольной точки.
Также pg_rewind копирует с нового мастера все служебные файлы и создает файл backup_label с указанием места, с которого необходимо восстанавливать данные из журнальных записей.
После выполнения указанных процедур новая реплика может быть запущена, и процесс startup начнет применять поступающие записи WAL.
Более подробно о применении утилиты pg_rewind можно узнать из документации.
Подведем итоги
- Физическая репликация — это процесс доставки записей WAL от мастера к реплике с их применением на реплике
- Физическая репликация используется для повышения отказоустойчивости и производительности системы
- Основным способом доставки записей WAL является потоковая репликация
- Архив WAL может использоваться в дополнение к потоковой репликации
- При использовании реплики в качестве резерва обслуживание клиентов может быть переключено на нее
Самопроверка
Вопрос 1
Какие ограничения имеются у метода физического резервного копирования? Выберите все верные варианты ответа:
Вопрос 2
Какие действия не могут выполняться на физической реплике? Выберите все верные варианты ответа:
Вопрос 3
Какие фоновые процессы работают на экземпляре реплики? Выберите все верные варианты ответа:
Вопрос 4
Какие значения параметра synchronous_commit обеспечивают фиксацию транзакций на реплике в синхронном режиме? Выберите все верные варианты ответа:
Вопрос 5
Выберите все способы, которыми можно решить проблему очистки на мастере версий строк, необходимых для выполнения запросов на реплике, в случае использования потоковой репликации: