Уровень 2.0
Предусловие:
- Изучена лекция 2 «Пулер соединений»
В этом задании:
- Понятие и средства логического резервного копирования и восстановления
- Копия отдельной таблицы
- Копия базы данных
- Копия всего содержимого кластера баз данных
Из курса DBA1 «Введение в администрирование СУБД Pangolin» известно, что резервное копирование в Pangolin может быть двух видов: логическое и физическое.
В данном курсе каждый из видов резервного копирования будет рассмотрен в отдельной теме. Начнем рассмотрение с логического резервного копирования.
Понятие и средства логического резервного копирования и восстановления
Понятие логического резервного копирования и восстановления
Под логическим резервным копированием понимается формирование набора команд SQL для создания объектов и наполнения их данными.
Логической копией является либо готовый к выполнению SQL-скрипт, либо архив специального формата, из которого может быть сформирован SQL-скрипт.
Выгрузка объектов при создании копии может выполняться выборочно. Скопировать можно содержимое всего кластера, отдельные базы данных или отдельные объекты баз данных.
Восстановление из логической копии осуществляется путем «проигрывания» SQL-команд, поэтому может выполняться на несовместимой платформе и на другой основной версии Pangolin при ее совместимости с исходной версией на уровне SQL-команд.
В то же время восстановление может занимать продолжительное время. В первую очередь это связано с выполнением команд по созданию индексов.
Логическое резервное копирование хорошо подходит для переноса данных между различными версиями Pangolin или различными платформами.
Средства логического резервного копирования и восстановления
В зависимости от цели создания копии могут использоваться различные средства логического резервного копирования и восстановления:
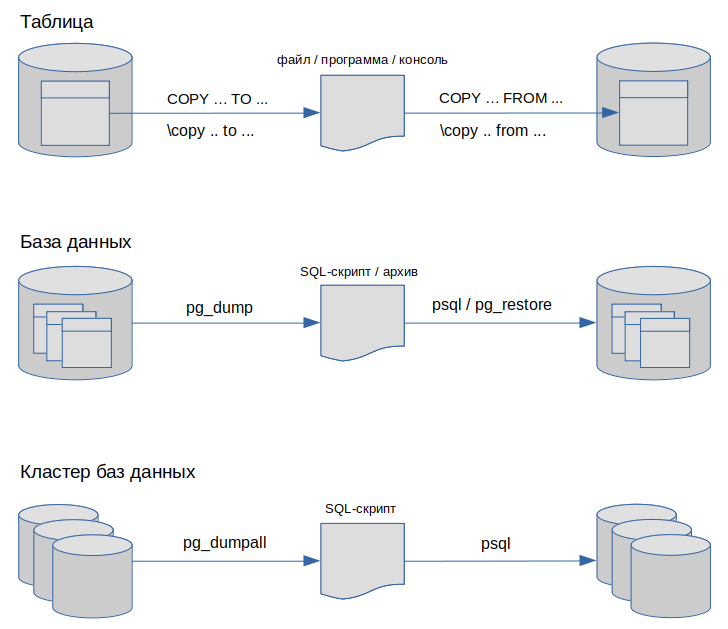
Для создания копии данных отдельной таблицы предназначена SQL-команда COPY ... TO ..., для восстановления данных из копии — COPY ... FROM .... Помимо этого, в psql имеются клиентские варианты данных команд: \copy ... to ... и \copy ... from ... соответственно.
Для создания копии базы данных или отдельных ее объектов предназначена утилита pg_dump.
Копия в pg_dump может быть создана либо в виде SQL-скрипта (формат plain), либо в одном из архивных форматов (custom, directory или tar).
В случае использования формата plain восстановление данных из копии осуществляется путем выполнения SQL-скрипта в psql или другом клиенте Pangolin.
Для восстановления данных из копии, созданной pg_dump в одном из архивных форматов, требуется отдельная утилита — pg_restore.
Утилита pg_dumpall позволяет сделать копию всех баз данных кластера, а также его глобальных объектов, таких как роли и табличные пространства. Создание копии возможно только в виде SQL-скрипта, поэтому для восстановления данных из нее используется psql.
Более подробно указанные средства будут рассмотрены ниже.
Копия отдельной таблицы
Выгрузка данных командой COPY
SQL-команда COPY является простым и эффективным средством выгрузки данных одной таблицы, определенных столбцов таблицы или результата выполнения запроса.
Данные можно выгружать в файл, передавать на вход другой программе, либо просто выводить на консоль. Соответствующие примеры приведены ниже:
--выгрузка в файл
COPY some_table TO '/dump/some_table';

--передача на вход программе
COPY some_table TO PROGRAM 'gzip > /dump/some_table.gz';

--вывод на консоль
COPY some_table TO STDOUT;
При этом выгрузка может выполняться в различных форматах:
text— текстовый (используется по умолчанию)csv— csv-формат (значения, разделенные запятыми)binary— внутренний двоичный формат
Формат данных указывается с использованием ключевого слова FORMAT, например:
COPY some_table TO '/dump/some_table.csv' WITH (FORMAT csv);
Загрузка данных командой COPY
Для загрузки данных в таблицу из файла (или программы, или с консоли) используется команда COPY ... FROM ..., например:
COPY some_table FROM '/dump/some_table';
Загружаемые данные при этом добавляются к уже имеющимся в таблице.
Если для таблицы указан список столбцов, то COPY ... FROM ... вставляет каждое поле из файла в соответствующий ему по порядку столбец из указанного списка. В случае отсутствия в этом списке каких-либо столбцов таблицы они получают значения по умолчанию.
По аналогии с COPY ... TO ... в команде COPY ... FROM ... может быть указан формат файла, разделитель и представление NULL.
Команда COPY ... FROM ... работает значительно быстрее набора команд INSERT, поскольку обслуживающему процессу не требуется много раз анализировать команды.
В случае возникновения ошибки (например, нарушения ограничения целостности) загрузка прерывается.
Частично загруженные данные не будут видны ни одной из активных транзакций, но будут занимать место на накопителе.
Вспомним из курса DBA2 «Администрирование Pangolin. Внутреннее устройство», что в Pangolin реализован механизм многоверсионности (MVCC) — при каждом изменении строки сохраняется новая ее версия. Каждая версия строки имеет набор свойств, определяющих ее видимость в снимках данных, используемых транзакциями.
Устаревшие версии строк, которые не видны ни в одном из имеющихся снимков данных, очищаются процессом автоочистки или могут быть очищены вручную командой VACUUM.
Следовательно, после прерывания загрузки данных командой COPY ... FROM ... может оказаться целесообразным выполнить команду VACUUM, не дожидаясь срабатывания автоочистки.
Полное описание команды COPY приведено в документации.
Метакоманда \copy
Команда COPY выполняется на сервере, следовательно, файлы, с которыми она работает, должны располагаться на сервере и быть доступны для чтения и записи пользователю, от имени которого запущен экземпляр Pangolin, то есть пользователю postgres.
Если же необходимо использовать файл на стороне клиента, то можно воспользоваться метакомандой \copy в psql, которая по сути является оберткой команды COPY, например:
dump_db=# \copy some_table to \home\postgres\dump\some_table
COPY 4
dump_db=# \copy some_table from \home\postgres\dump\some_table
COPY 4
Параметры метакоманды \copy соответствуют параметрам команды COPY.
Копия базы данных
Общие сведения об утилите pg_dump
Для создания логической копии базы данных или ее отдельных объектов предназначена утилита pg_dump.
Утилита pg_dump воспроизводит последовательность команд создания объектов базы данных (DDL) и наполнения таблиц данными (COPY или INSERT).
Простейший вариант использования утилиты pg_dump показан в следующем примере:
[postgres@ServerName ~]$ pg_dump -d some_db -f ~/dump/some_db.sql
Приведенная команда выполнит выгрузку базы данных some_db в файл "~/dump/some_db.sql", содержащий SQL-скрипт для дальнейшего восстановления базы данных. Без указания файла с использованием ключа -f SQL-скрипт будет направлен в стандартный вывод.
В данном случае из параметров подключения указано только имя базы данных (-d some_db). Значения остальных параметров подключения, по аналогии с psql, могут быть либо явно указаны с использованием ключей -h (имя хоста), -p (номер порта) и U (имя роли), либо получены из соответствующих переменных окружения. Если ни первое, ни второе не задано, будут использованы значения по умолчанию.
Благодаря указанным опциям pg_dump может быть подключен к базе данных по сети, а значит логическая копия может быть создана на удаленном сервере.
Выгрузка в данном случае по умолчанию сделана в формате SQL-скрипта (формат plain), который может быть выполнен в psql следующим образом:
[postgres@ServerName ~]$ psql -d some_db_restored -f ~/dump/some_db.sql
Также имеется возможность выгрузки в архивных форматах (custom, directory и tar). Для указания формата используется ключ -F или --format.
Для восстановления базы данных из архивных форматов требуется отдельная утилита pg_restore. Более подробно архивные форматы будут рассмотрены ниже.
Необходимо отметить, что по умолчанию pg_dump не генерирует команды для создания объекта базы данных (CREATE DATABASE). Поэтому в примере выше использовалась заранее подготовленная база данных для выполнения в ней SQL-скрипта.
При этом, как правило, база данных для восстановления должна быть создана на основе чистой шаблонной базы данных template0. Если использовать шаблон template1, то загружаемые объекты уже могут находиться в базе данных для восстановления, так как базы данных обычно создаются на основе шаблона template1, допускающего изменения.
Однако команда создания базы данных для восстановления может быть добавлена утилитой pg_dump путем использования ключа --create, например:
[postgres@ServerName ~]$ pg_dump -d some_db --create | grep 'CREATE DATABASE'
CREATE DATABASE some_db WITH TEMPLATE = template0 ENCODING = 'UTF8' LOCALE_PROVIDER = libc LOCALE = 'en_US.UTF-8';
Как видно, pg_dump в качестве шаблона указал template0.
Важно отметить, что pg_dump не выгружает глобальные объекты кластера (такие, как роли и табличные пространства), поэтому необходимо заранее позаботиться об их наличии в том кластере баз данных, в котором будет выполняться восстановление.
Помимо этого, в восстановленной базе данных отсутствует статистика, которая используется оптимизатором при планировании выполнения запросов. К указанной статистике в том числе относятся: количество строк и страниц в отношениях, число уникальных значений в столбцах, список наиболее частых значений в столбцах и т. д.
Отсутствие актуальной статистики по данным негативно сказывается на производительности Pangolin. Поэтому ее необходимо своевременно обновлять.
Вспомним из курса DBA2 «Администрирование Pangolin. Внутреннее устройство», что обновление статистики выполняется в процессе автоочистки, а также может быть выполнено вручную с использованием команды ANALYZE или VACUUM ANALYZE.
В связи с этим, после восстановления базы данных из логической копии рекомендуется выполнить команду ANALYZE, не дожидаясь срабатывания автоочистки.
Полное описание утилиты pg_dump приведено в документации.
Настройка параметров выгрузки
Утилита pg_dump обладает гибкими возможностями по настройке параметров выгрузки.
В частности, может быть ограничен набор выгружаемых объектов. Для этого предусмотрены следующие ключи:
-t шаблонили--table=шаблон— выгрузить только таблицы, соответствующие шаблону. Шаблон интерпретируется по тем же правилам, что применяются в метакоманде\dвpsql-T шаблонили--exclude-table=шаблон— не выгружать таблицы, соответствующие шаблону-n шаблонили--schema=шаблон— выгрузить только схемы, соответствующие шаблону-N шаблонили--exclude-schema=шаблон— не выгружать схемы, соответствующие шаблону
Также имеется возможность выгрузки только команд DDL или только данных:
-sили--schema-only— выгрузить только командыDDL(определение объектов базы данных)-aили--data-only— выгрузить только данные, без командDDL
Если загрузка будет выполняться в базу данных, в которой уже имеются выгружаемые объекты, то при выгрузке может быть указан ключ -c или --clean, который даст указание pg_dump генерировать команды DROP перед созданием объектов.
Также, как уже было сказано выше, при использовании ключа -C или --create будут генерироваться команды создания базы данных и подключения к ней.
Если планируется восстановление базы данных в кластере с другим набором ролей, то могут оказаться полезными следующие ключи:
Oили--no-owner— не генерировать команды, устанавливающие владельцев объектов-x,--no-aclили--no-privileges— не генерировать команды, устанавливающие права доступа на объекты
Для наполнения таблиц данными pg_dump по умолчанию использует команду COPY. Однако это поведение можно изменить путем указания ключа --column-inserts или --attribute-inserts. В этом случае для каждой строки таблицы будет использована отдельная команда INSERT.
Скорость восстановления при этом значительно снизится, однако станет технически возможным восстановление на других СУБД, не являющихся версиями PostgreSQL. Конечно, в этом случае необходимо учитывать и другие особенности реализации языка SQL в каждой отдельно взятой СУБД.
Архивные форматы pg_dump
Рассмотренный выше формат plain, являющийся по сути SQL-скриптом, имеет некоторые ограничения применения.
В частности, данный формат не имеет возможности выборочного восстановления — выбор объектов возможен только на этапе создания копии, но не восстановления. Справедливости ради необходимо отметить, что выборочное восстановление все же возможно путем «ручного» редактирования SQL-скрипта.
Помимо этого, выгрузка и загрузка в формате plain может выполняться только в одном потоке.
Указанные недостатки в той или иной степени могут быть компенсированы использованием архивных форматов:
custom(-F cили--format=custom) — файл с данными и оглавлениемdirectory(-F dили--format=directory) — каталог файлов с данными и файлом-оглавлениемtar(-F tилиformat=tar) — архивtar, содержащий те же файлы, что содержатся в каталоге форматаdirectory
Для восстановления данных из указанных форматов требуется утилита pg_restore.
Формат custom
В файле формата custom имеется оглавление, позволяющее выбирать объекты на этапе восстановления.
Выбор объектов для восстановления может быть выполнен с использованием ключей утилиты pg_restore, которые в основном совпадают с ключами утилиты pg_dump.
Утилита pg_restore похожа на утилиту pg_dump в том смысле, что обе они на выходе создают SQL-скрипт. При этом pg_restore по умолчанию сразу его выполняет (psql не нужен). Однако, если указать ключ -f имя_файла или --file=имя_файла, то скрипт будет сохранен в файл.
Восстановление копии может выполняться в несколько потоков. Для этого в pg_restore необходимо использовать ключ -j число_потоков или --jobs=число_потоков. Однако создание копии возможно только в один поток.
Полное описание утилиты pg_restore приведено в документации.
Формат directory
При выгрузке копии в формате directory (pg_dump -F d) создается каталог, содержащий файл-оглавление и по одному файлу на каждый выгружаемый объект.
Формат directory обладает теми же возможностями, что и формат custom, а также поддерживает создание копии в несколько потоков. Для этого в pg_dump необходимо использовать ключ -j число_потоков или --jobs=число_потоков.
Согласованность данных при выгрузке в этом случае обеспечивается механизмом экспорта снимков: в начале транзакции с уровнем изоляции REPEATABLE READ одного из потоков экспортируется снимок данных (с использованием функции pg_export_snapshot), который используется транзакциями в других потоках (с применением команды SET TRANSACTION SNAPSHOT).
Формат tar
Формат tar фактически представляет собой tar-архив содержимого каталога в формате directory, однако не поддерживает сжатие и многопоточность (ни при создании копии, ни при восстановлении из нее).
Данный формат может оказаться удобным только при необходимости выборочного восстановления.
Копия всего содержимого кластера баз данных
Как было сказано выше, утилита pg_dump обеспечивает создание копии отдельной базы данных без выгрузки глобальных объектов кластера, таких как роли или табличные пространства.
Для создания копии всего содержимого кластера баз данных предназначена утилита pg_dumpall.
Утилита обеспечивает выгрузку данных только в виде SQL-скрипта, в котором содержатся как команды, относящиеся к созданию и наполнению объектов отдельных баз данных, так и команды по созданию глобальных объектов кластера.
На самом деле pg_dumpall для выгрузки баз данных использует ту же утилиту pg_dump.
Утилита pg_dumpall должна иметь доступ ко всем объектам всех баз данных, поэтому обычно ее запускают от имени суперпользователя (postgres).
Для начала работы утилите pg_dumpall требуется подключиться к какой-либо базе данных. По умолчанию подключение выполняется к базе данных postgres, а в случае ее отсутствия — template1. Для указания другой базы данных используется ключ -l имя_бд или --database=имя_бд.
Простейший пример создания резервной копии всего кластера представлен ниже:
[postgres@ServerName ~]$ pg_dumpall -f ~/dump/pangolin_cluster.sql
Так как результатом работы pg_dumpall может быть только SQL-скрипт, параллельная выгрузка не поддерживается.
Поэтому кластеры большого объема могут выгружаться долго.
Однако имеется возможность выгрузки только глобальных объектов. Для этого используется ключ -g или --globals-only.
В этом случае базы данных можно выгрузить отдельно с использованием утилиты pg_dump в параллельном режиме в формате directory.
Необходимо отметить, что в ходе своей работы утилиты pg_dump и pg_dumpall не выполняют изменений данных и не накладывают исключительных блокировок, тем самым не препятствуют доступу других пользователей к базе данных ни для чтения, ни для записи.
Полное описание утилиты pg_dumpall приведено в документации.
Итоги
- Для создания логических копий предусмотрен набор стандартных средств: команда
COPY ... TO ..., утилитыpg_dumpиpg_dumpall - Для восстановления данных из логических копии могут использоваться: команда
COPY ... FROM ..., клиентpsqlи утилитаpg_restore - Логическое резервное копирование позволяет создавать копии отдельной таблицы, базы данных или кластера баз данных
- Логической копией является либо SQL-скрипт, либо архивные файлы специального формата, из которых может быть сформирован SQL-скрипт
- Логическая копия может быть восстановлена на иной платформе и другой основной версии Pangolin
Самопроверка
Вопрос 1
Какие объекты кластера баз данных могут быть выгружены с использованием утилиты pg_dump? Выберите все верные варианты ответа:
Вопрос 2
Куда могут быть направлены выгружаемые данные в команде COPY ... TO ...? Выберите все верные варианты ответа:
Вопрос 3
Куда могут быть направлены выгружаемые данные в команде COPY ... TO ...? Выберите все верные варианты ответа:
Вопрос 4
Какие форматы утилиты pg_dump поддерживают параллельное восстановление? Выберите все верные варианты ответа:
Вопрос 5
С использованием каких средств могут быть выгружены табличные пространства?