Уровень 2.0
Предусловие:
- Изучена лекция «Обновление Pangolin»
В этом задании вы узнаете о:
- Свойствах высокой доступности
- Понятии кластера
- Понятии сбоя и split-brain
- Протоколах консенсуса
- Компонентах кластера Pangolin
Обеспечение высокой доступности
Доступность информационной системы определяется совокупностью свойств, среди которых можно выделить следующие:
- Отказоустойчивость — свойство системы, характеризующее ее способность продолжать обслуживание клиентов на чтение и запись в случае сбоя
- Надежность — свойство системы, характеризующее ее способность восстанавливать данные без потерь после возникновения сбоя
- Масштабируемость — свойство системы, характеризующее ее способность адаптироваться под увеличение рабочей нагрузки путем добавления и перераспределения вычислительных ресурсов
Основным показателем доступности информационной системы является процент времени ее доступности для обслуживания клиентов от общего времени эксплуатации (далее — процент доступности).
Значение процента доступности используется в соглашении уровня сервиса (SLA, Service Level Agreement) при построении информационной системы.
На значение процента доступности влияют простои системы, связанные как с возникающими отказами, так и выполнением планового обслуживания.
Примеры значений показателя uptime для высокодоступных (High Availability, HA) систем:
| Процент доступности | Продолжительность простоя в год |
|---|---|
| 99 % | 3,65 дня |
| 99,9 % | 8,76 ч. |
| 99,99 % | 52,56 мин. |
| 99,999 % | 5,26 мин. |
Другими показателями доступности информационной системы являются:
- RTO (Recovery Time Objective) — целевое время восстановления — период времени, за который система должна восстановиться
- RPO (Recovery Point Objective) — целевая точка восстановления — период времени, за который допускается потеря данных при сбое
Показатель RTO применяется для оценки свойства отказоустойчивости, RPO — для оценки свойства надежности.
Для оценки свойства масштабируемости используется либо время отклика при выполнении запроса, либо общая пропускная способность системы по выполнению запросов.
Понятие кластера
Для построения информационных систем высокой доступности используются кластерные решения.
В этом случае под кластером понимают не набор баз данных, как в терминологии PostgreSQL, а набор вычислительных узлов — серверов с базами данных и других серверов.
Основа обеспечения высокой доступности — дублирование различных узлов кластера. Дублироваться могут как серверы баз данных, так и другие, например серверы, являющиеся точкой входа (подробности ниже).
Для синхронизации данных между серверами могут использоваться ранее рассмотренные механизмы физической и логической репликации. Помимо этого, для выборочной синхронизации также могут использоваться обертки сторонних данных расширения postgres_fdw.
Однако, как правило, в качестве механизма синхронизации данных при построении кластеров высокой доступности применяется физическая репликация.
Использование физической репликации позволяет повысить надежность и отказоустойчивость кластера, а также его масштабируемость для читающих транзакций.
Поскольку физическая репликация является однонаправленным процессом, в составе кластера может быть один ведущий сервер (мастер) и несколько ведомых серверов (реплик).
Для обеспечения отказоустойчивости нужны средства обнаружения сбоев и их корректной обработки. Если из строя вышел мастер, то его должна заменить одна из реплик с повышением своего статуса (failover). После этого бывший мастер должен быть возвращен в строй в роли реплики.
В лекции «Физическая репликация» рассматривалась процедура повышения статуса реплики до мастера и возвращения в строй бывшего мастера, на котором произошел сбой.
Однако, рассмотренную процедуру может выполнить исключительно пользователь с правами администратора.
Для автоматизации обработки сбоев требуются внешние программные средства, о которых вы узнаете далее.
Но перед этим разберемся с самим понятием сбоя и процедурой его обработки при использовании кластера на основе физической репликации.
Понятие сбоя и split-brain
Под сбоем в кластере понимают ситуацию, при которой как минимум один из узлов не подтверждает свою работоспособность другим узлам.
Во-первых, это может произойти из-за аппаратного или программного сбоя на сервере. Такой сбой относят к категории «отказ узла».
Во-вторых, сбой может произойти на сетевом оборудовании. В этом случае все узлы продолжают функционировать, но одна часть узлов теряет связь с другой. Такой сбой относят к категории «разделение сети».
Так или иначе для обнаружения сбоя узлы кластера обмениваются сообщениями (heartbeat). Если от одного из узлов в течение определенного времени не поступает указанных сообщений, то фиксируется сбой.
При этом истинная причина недоступности узла может быть не определена.
Если причиной является сетевой сбой или, например, наличие задержек в доставке пакетов, то узел продолжает работать. Более того, если он является мастером, то продолжает обслуживать клиентов как на чтение, так и на запись.
Для примера рассмотрим простейший случай, когда кластер состоит из двух узлов: мастера и реплики.
Реплика, не получая от мастера heartbeat-сообщений какое-то время, считает, что на мастере произошел сбой. Кластер должен обработать ситуацию сбоя, то есть инициировать процедуру переключения (failover).
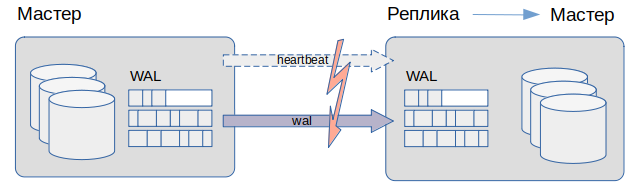
В результате в кластере оказывается два работающих мастера, каждый из которых может менять данные независимо от другого.
Данные на узлах в этом случае будут несогласованы и при восстановлении часть из них будет потеряна.
Такая ситуация называется split-brain.
Чтобы не допускать split-brain-эффекта, необходим какой-либо механизм формирования общего представления (консенсуса) узлов кластера о состоянии друг друга.
Протоколы консенсуса
Кластеры Pangolin, как и PostgreSQL, строятся по принципу shared nothing. Узлы не имеют общих устройств хранения, а синхронизация данных на них обеспечивается репликацией.
Поэтому формирование консенсуса у узлов кластера может быть обеспечено только путем обмена сообщениями между ними. Узлы должны «договориться» между собой и прийти к общему представлению о состоянии друг друга.
Для этого им необходим протокол распределенного консенсуса.
Существуют протоколы консенсуса, применяемые для реализации глобальных (распределенных) транзакций, такие как 2PC и 3PC (PC — Phase Commit). Эти протоколы обеспечивают распределенную атомарность транзакций, однако не устойчивы к сбоям типа «разделение сети».
Другой класс протоколов консенсуса основан на большинстве голосов — кворуме. В случае разделения сети узлы большего сегмента сети (по количеству узлов), сохраняя связь между собой, «понимают», что составляют большинство.
Если среди узлов, составляющих большинство, есть мастер, то он продолжает работать как на чтение, так и на запись. Если среди них мастера нет, то инициируется процедура голосования по выбору нового мастера.
Работа узлов меньшинства при этом блокируется (по крайней мере на запись) для исключения ситуации split-brain.
Рассмотрим обработку ситуации разделения сети в простейшем случае, когда в кластере есть один мастер и одна реплика.
Однако, для применения кворумного протокола двух узлов недостаточно, поэтому в кластер должен быть добавлен дополнительный узел, назначение которого заключается в обеспечении большинства. Такой узел назовем арбитром.
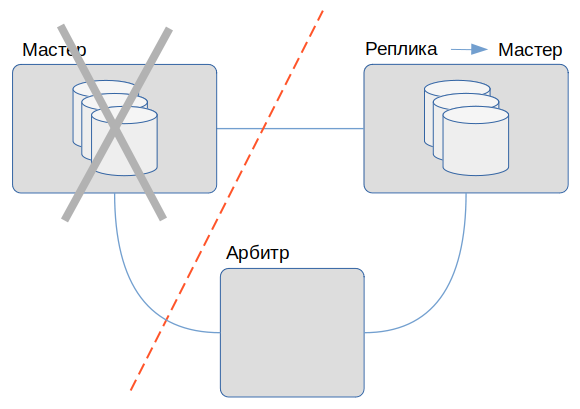
Как видно на рисунке, мастер в результате сбоя оказался в одном сегменте сети, а реплика и арбитр — в другом.
Реплика и арбитр при этом составляют кворум, а значит, могут продолжить свою работу, и более того — должны выбрать нового мастера из своего сегмента сети. Поскольку реплика является единственным кандидатом на роль мастера, то выбирается именно она.
Оказавшись в меньшинстве, мастер прекращает свою работу (по крайней мере на запись).
Тут стоит сделать важное замечание. За формирование представления о состоянии узлов и управление ими отвечают внешние компоненты. Экземпляр Pangolin не имеет представления о том, что является частью кластера, и не может управлять собой.
Поэтому, когда принято решение о необходимости блокировки экземпляра Pangolin на узле мастера, сам экземпляр может продолжать обслуживание клиентов на запись до того момента, пока его не остановят. Более того, сбой может произойти на самом компоненте, управляющем экземпляром Pangolin.
В связи с этим в кластере должен быть предусмотрен какой-либо механизм «ограждения» сбойного мастера от обслуживания клиентов.
В качестве такого механизма, например, может выступать сторожевой таймер (watchdog timer) ОС Linux, который перезагружает операционную систему, если какое-то время нет связи с компонентами консенсуса.
Примером кворумного протокола является протокол Raft, который используется для обеспечения консенсуса в таких распределенных хранилищах конфигурации (Distributed Configuration Store, DCS) как Consul, etcd и Pangolin DCS.
Компоненты кластера Pangolin
Для реализации кластерного решения на базе СУБД Pangolin используют:
- Сервер Pangolin
- Оркестратор — Pangolin Manager
- Распределенное хранилище (DCS) — etcd или Pangolin DCS
- Точка входа — HAProxy, виртуальный IP-адрес, libpq и так далее
Для управления экземплярами Pangolin используется оркестратор Pangolin Manager, который работает на каждом из узлов с экземплярами Pangolin.
Pangolin Manager — доработанная версия Python-приложения Patroni, выполняет основные задачи:
- Выступает в роли агента экземпляра Pangolin, то есть выполняет функции по его управлению (конфигурированию, запуску, остановке и так далее)
- Реализует логику управления кластером, в том числе процедуру аварийного переключения (failover) мастера на реплику
Для разделения общего представления о состоянии узлов Pangolin Manager использует распределенное хранилище (DCS), в роли которого может выступать либо etcd, либо Pangolin DCS, являющееся доработанной версией etcd.
Указанные DCS представляют собой распределенную базу данных типа «ключ-значение» и используют алгоритм Raft для обеспечения консенсуса.
Хранилище etcd работает независимо от Pangolin, может устанавливаться как на узлах с экземплярами Pangolin, так и на отдельных узлах. В то время как Pangolin DCS является частью Pangolin Manager и запускается вместе с Pangolin Manager. Однако, для использования Pangolin DCS на узле без экземпляра Pangolin, Pangolin Manager может быть установлен в упрощенном варианте, обеспечивающим запуск Pangolin DCS.
Наконец, для подключения клиентов к кластеру необходима единая точка входа, которая обеспечивает направление клиентов на нужный узел.
В качестве точки входа в том числе могут использоваться:
- HAProxy — прокси-сервер и балансировщик нагрузки, функционирующий на уровне TCP и HTTP
- Виртуальный IP-адрес — при смене ролей узлов на сетевой интерфейс нового мастера назначается виртуальный IP-адрес старого мастера
- Библиотека
libpq— в строке подключения может быть указано несколько узлов, а также параметры, определяющие порядок подключения к узлам и необходимые свойства сеанса (например, только чтение)
В дополнение к этому, перед точкой входа может использоваться пулер соединений — Pangolin Pooler (подробнее в лекции «Пулер соединений» курса DBA3).
Вот пример конфигурации кластера Pangolin с одним мастером и одной репликой:
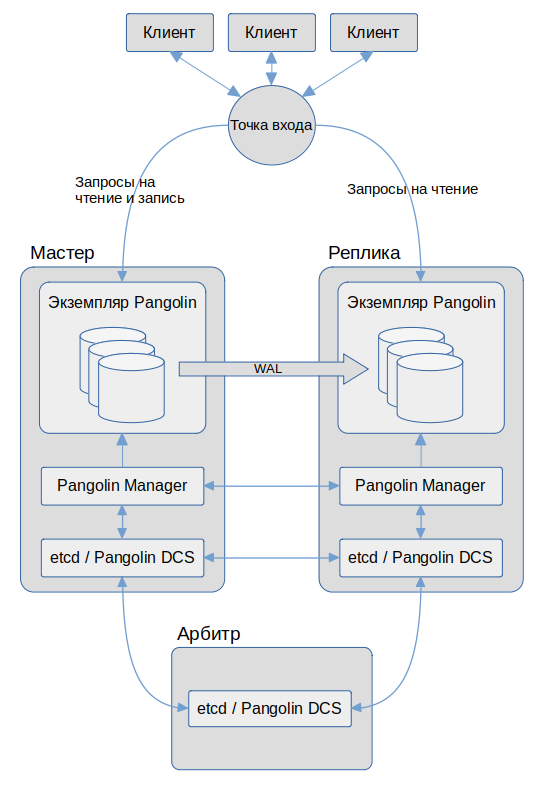
Как видно из рисунка, для обеспечения консенсуса потребовался дополнительный узел под названием «Арбитр». На этом узле работает только компонент распределенного хранилища.
Также компоненты распределенного хранилища работают на узлах мастера и реплики.
Управление экземплярами Pangolin на данных узлах обеспечивает Pangolin Manager во взаимодействии с DCS.
Запросы клиентов направляются точкой входа в зависимости от их типа. Запросы на чтение могут быть направлены как на мастер, так и на реплику. Запросы на запись направляются только на мастер.
Вы научитесь использовать Pangolin Manager в лабораторной работе.
Итоги
- Кластер высокой доступности в Pangolin строится на основе механизма физической репликации
- Для управления кластером в целом и экземплярами Pangolin в частности используется оркестратор Pangolin Manager
- Для решения проблемы консенсуса применяется распределенное хранилище конфигурации (DCS) с использованием алгоритма Raft
Самопроверка
Вопрос 1
Что означает показатель RTO?
Вопрос 2
В каком случае в кластере возникает split-brain-эффект?
Вопрос 3
Какой протокол консенсуса является устойчивым к сбоям типа «разделение сети»?
Вопрос 4
Какие компоненты являются необходимыми для построения кластера Pangolin? Выберите все верные варианты ответа