Уровень 2.0
Журнал предзаписи
Предусловие:
- Изучен модуль «Кеш буферов» данного курса
В этом задании вы узнаете о:
- Назначении журнала предзаписи
- Структуре журнала предзаписи
- Процессе журналирования
- Режимах записи журнала предзаписи
- Уровне журнала предзаписи
- Проблеме неатомарности записи
Назначение журнала предзаписи
Как теперь известно, любые изменения в кластере баз данных выполняются в оперативной памяти. Страницы данных изменяются в кеше буферов, статусы транзакций — в кеше журнала CLOG.
При этом запись грязных страниц из кеша буферов в файловую систему происходит далеко не сразу.
Это выполняется с определенной периодичностью процессами checkpointer и background writer (речь о которых пойдет в следующей теме), а также в случае их вытеснения обслуживающими процессами.
Похожим образом осуществляется запись грязных страниц из кеша журнала CLOG.
Она выполняется либо периодически процессом checkpointer, либо — при необходимости вытеснения — в соответствии с алгоритмом SLRU (Simple Least Recently Used — простой алгоритм вытеснения наименее недавно используемых данных).
Таким образом, страницы данных, хранимые на энергонезависимых накопителях, не обеспечивают согласованность без страниц, находящихся в оперативной памяти.
Ясно, что в случае сбоя содержимое оперативной памяти теряется и необходим какой-либо механизм восстановления потерянных данных.
Такой механизм в Pangolin, конечно, имеется. Суть его заключается в ведении журнала предзаписи (Write-Ahead Log — WAL).
Любое изменение данных в оперативной памяти, требующее долговременного хранения, журналируется, то есть на энергонезависимом накопителе сохраняется запись, содержащая информацию, достаточную для воспроизведения того же изменения при восстановлении.
Журналируются следующие действия:
- Изменения страниц в кеше буферов
- Изменения статусов транзакций в кеше журнала
CLOG - Операции с файлами: создание, удаление файлов и каталогов
В то же время некоторые действия не журналируются:
- Изменения во временных таблицах и последовательностях
- Изменения в нежурналируемых (созданных с параметром
UNLOGGED) таблицах и последовательностях
Время жизни временных таблиц и последовательностей ограничено временем жизни создавшего их обслуживающего процесса, поэтому они не подлежат восстановлению в случае сбоя.
Также не восстанавливаются таблицы и последовательности, созданные с явным указанием UNLOGGED.
Журнальная запись попадает в файловую систему строго до записи соответствующей измененной страницы. Это требование обеспечивает возможность восстановления согласованности после сбоя.
Именно поэтому журнал WAL называется журналом предзаписи.
Сохранение записей журнала WAL ведется последовательным доступом, что значительно эффективнее случайного доступа при записи грязных страниц.
Помимо этого, журнальные записи могут быть меньше по объему по сравнению со страницами данных.
Журнал WAL используется не только для восстановления данных после сбоя. Он также используется в процессах репликации и резервного копирования.
Структура журнала предзаписи
Структура журнальной записи
На логическом уровне журнал WAL представляет собой последовательность записей, каждая из которых содержит информацию о совершенной операции.
Помимо этого каждая запись имеет заголовок, содержащий следующую информацию:
- Номер транзакции, в которой совершена операция
- Контрольная сумма (CRC) записи
- Менеджер ресурсов, способный интерпретировать содержание записи
Записи имеют разный размер, и каждая из них соответствует одному из форматов, который определяется менеджером ресурсов.
Например, есть менеджеры ресурсов для баз данных, таблиц, различных типов индексов, статусов транзакций и т. д.
Полный список менеджеров ресурсов можно получить с использованием команды pg_waldump -r list.
При этом в заголовке записи отсутствует информация для идентификации записи.
Для этой цели служит 64-битное смещение от начала журнала до журнальной записи — LSN (Long Sequence Number).
Для смещения LSN используется специальный тип данных — pg_lsn.
Обратите внимание, что в заголовке журнальной записи имеется контрольная сумма.
Контрольные суммы всегда вычисляются для журнальных записей, поскольку именно журнал предзаписи обеспечивает свойство долговечности транзакций.
Кеш журнала предзаписи
Даже журнальные записи не сразу попадают на энергонезависимые накопители. Для них также имеется свой небольшой кеш в разделяемой памяти.
Размер кеша задается конфигурационным параметром wal_buffers. Значение по умолчанию составляет 1/32 от размера кеша буферов.
Кеш записей WAL организован в виде кольцевого буфера.
Кеширование организовано по принципу FIFO (First In — First Out) — «первым вошел — первым вышел».
В результате всегда есть запись, являющаяся последней из сохраненных в сегментах WAL, а также последняя вставленная запись. В ненагруженных системах они могут совпадать.
Позиции в журнале WAL, соответствующие указанным записям, можно узнать с использованием следующих функций:
pg_current_wal_lsn— позиция, следующая за последним байтом последней из сохраненных записей, «позиция записи»pg_current_wal_insert_lsn— позиция, следующая за последним байтом последней вставленной записи, «позиция вставки»
Например, позицию записи можно получить следующим образом:
postgres=# SELECT pg_current_wal_lsn();
 pg_current_wal_lsn
--------------------
 9/8C61AB98
(1 строка)
LSN представляется в виде двух 32-битных чисел в шестнадцатеричном представлении, разделенных слешем.
Сегменты журнала предзаписи
Журнальные записи сохраняются в каталоге pg_wal каталога данных, последовательно заполняя файлы, которые называются сегментами журнала.
Размер сегмента журнала может быть получен с использованием параметра pg_wal_size, доступного только для чтения.
Изменение размера сегмента возможно только при инициализации кластера: initdb --wal-segsize.
По умолчанию размер сегмента составляет 16 MB.
Содержимое каталога pg_wal можно посмотреть с использованием функции pg_ls_waldir:
postgres=# SELECT * FROM pg_ls_waldir() limit 5;
           name           |   size   |      modification
--------------------------+----------+------------------------
 0000000100000009000000B8 | 16777216 | 2025-08-11 15:17:38+03
 00000001000000090000009B | 16777216 | 2025-08-11 15:11:48+03
 0000000100000009000000A6 | 16777216 | 2025-08-11 15:12:36+03
 0000000100000009000000BD | 16777216 | 2025-08-11 15:17:44+03
 0000000100000009000000B4 | 16777216 | 2025-08-11 15:17:39+03
(5 строк)
Имя сегмента (поле name) состоит из двух частей:
- Первые 8 шестнадцатеричных знаков — номер линии времени (используется при восстановлении из резервной копии)
- Оставшиеся 16 шестнадцатеричных знаков — старшие разряды LSN-записей внутри сегмента
Обратиться к содержимому журнальной записи можно либо с использованием утилиты pg_waldump, либо с использованием расширения pg_walinspect.
Анализ содержимого сегментов WAL будет выполнен в лабораторной работе.
Процесс журналирования
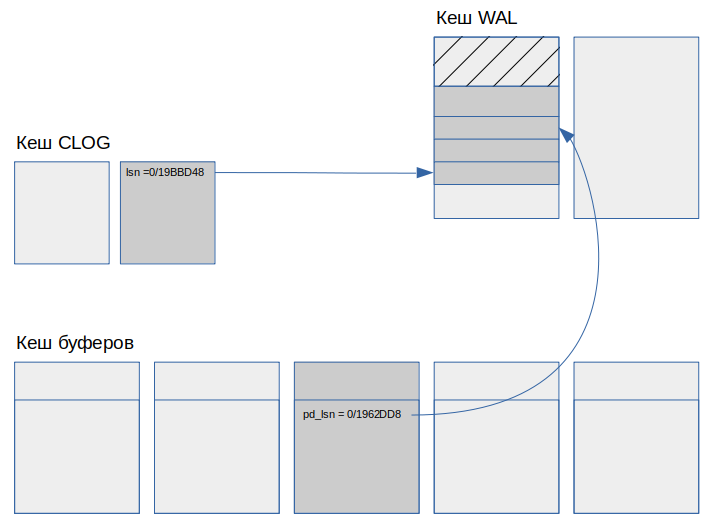
Всякий раз при изменении страницы в кеше буферов формируется соответствующая журнальная запись.
Указанная запись помещается в конец последней незаполненной страницы в кеше WAL, а ссылка на нее записывается в заголовок измененной страницы в поле pd_lsn.
Если быть более точным, то в поле pd_lsn записывается LSN не самой записи, а позиция, следующая за последним байтом записи, то есть LSN следующей записи.
Поле pd_lsn в заголовке измененной страницы записывается с целью гарантии того, что соответствующая журнальная запись окажется на диске раньше, чем сама измененная страница.
Эта информация используется также при восстановлении для принятия решения о необходимости применения журнальной записи к странице данных.
Процедура восстановления после сбоя с использованием журнала предзаписи будет рассмотрена в следующей лекции.
Аналогичным образом формируются и журнальные записи при изменении статусов транзакций в журнале CLOG. Однако ссылка на журнальную запись хранится не в заголовке страницы в журнале CLOG, а отдельно — в оперативной памяти.
Записи попадают в журнал в той последовательности, в которой они были сформированы.
Журнал является общим для всех журналируемых изменений во всем кластере баз данных.
В зависимости от режима записи журнала (которые будут рассмотрены ниже) в определенный момент времени журнальные записи попадают на энергонезависимый накопитель.
При этом строго контролируется порядок записи: сначала журнальная запись, потом измененная страница.
Если при вытеснении грязной страницы из кеша буферов окажется, что соответствующая журнальная запись еще не сброшена на накопитель, то это будет сделано в принудительном порядке.
Режимы записи журнала предзаписи
В соответствии с требованием долговечности ACID при фиксации транзакции ее изменения должны быть гарантированно записаны на энергонезависимом хранилище.
Однако, как теперь известно, при реализации требований ACID могут допускаться некоторые послабления в угоду производительности.
Реализация требования долговечности в Pangolin не является исключением.
Сохранение журнальных записей на энергонезависимые накопители может выполняться в следующих режимах:
- Синхронный: команда фиксации транзакции возвращает управление только после сохранения соответствующих журнальных записей на накопителях
- Асинхронный: команда фиксации немедленно возвращает управление, а журнальные записи сохраняются в фоновом режиме, при таком режиме часть данных может быть потеряна в случае сбоя
За определение режима отвечает конфигурационный параметр synchronous_commit, значение по умолчанию которого установлено в on. Для сохранения журнала в асинхронном режиме требуется установить его значение в off.
Однако на самом деле фоновое сохранение журнальных записей в асинхронном режиме выполняется постоянно, вне зависимости от выбранного режима. Синхронный режим служит дополнением к асинхронному для строгого соблюдения требования долговечности.
Асинхронный режим записи
За сохранение журнальных записей в асинхронном режиме отвечает процесс walwriter.
Процесс выполняет сброс записей с периодичностью, задаваемой параметром wal_writer_delay (по умолчанию 200 мс), или по достижении объема в кеше, задаваемого параметром wal_writer_flush_after (по умолчанию 1 MB).
Проснувшись после очередной паузы, процесс сбрасывает полностью записанные страницы в кеше в сегменты WAL, начиная со страницы, соответствующей позиции записи, и заканчивая страницей, расположенной в конце кеша.
Последняя недозаполненная страница в этом случае не сбрасывается.
Однако если такая страница является единственной в кеше, то она все же будет записана в сегмент WAL.
При этом страница, соответствующая позиции записи, совершенно не обязательно будет расположена в первом буфере кеша.
Поэтому, с учетом устройства кольцевого буфера, для сброса всех заполненных страниц может потребоваться два прохода: первый — со страницы, соответствующей позиции записи до конца кеша, второй — со страницы, расположенной в первом буфере, и до страницы, начиная с которой выполнялась запись в предыдущий проход.
Помимо этого, после двух проходов также может остаться недозаполненная страница, которая, как было сказано выше, вместе с заполненными сразу не сбрасывается.
В результате, если журнальная запись находится в недозаполненной странице, то для того, чтобы она попала в сегмент WAL на накопителе, может потребоваться до трех проходов процессом walwriter с паузами wal_writer_delay.
Таким образом, максимальное время, за которое могут быть потеряны данные после фиксации транзакции в асинхронном режиме, составляет 3 x wal_writer_delay единиц времени (со значением по умолчанию 0,6 с).
Необходимо отметить, что даже в асинхронном режиме журнальные записи могут иногда сбрасываться на накопители синхронно.
Это происходит в случае вытеснения грязной страницы из кеша буферов.
Поскольку грязная страница должна быть записана после сброса соответствующей журнальной записи, обслуживающий процесс сбрасывает ее сам, в случае если процесс walwriter еще не успел это сделать.
Синхронный режим
В синхронном режиме при фиксации транзакции на накопитель обслуживающим процессом сбрасываются все журнальные записи, накопленные (и еще не сброшенные процессом walwriter) в рамках фиксируемой транзакции.
Тем самым обеспечивается свойство долговечности транзакций.
Однако операция синхронизации с энергонезависимой памятью является дорогой.
Поэтому даже в синхронном режиме предусмотрена небольшая оптимизация, не влияющая на обеспечение долговечности.
Оптимизация заключается в задержке по времени сброса журнальных записей, в надежде на то, что за время задержки будут зафиксированы другие параллельные транзакции, и сброс журнальных записей можно будет сделать сразу для всех вместе.
Время задержки задается параметром commit_delay. По умолчанию значение commit_delay = 0, что означает, что оптимизация отключена.
Если же значение commit_delay не равно 0, то задержка будет срабатывать только в случае наличия не менее commit_siblings активных параллельных транзакций.
Эффект от применения данной оптимизации может быть заметен при большом количестве коротких транзакций в системе.
Таким образом, выбор между синхронным и асинхронным режимами записи журнала — это выбор между надежностью и производительностью.
Стоит отметить, что параметр synchronous_commit может быть задан на уровне транзакций.
Если в системе лишь небольшая часть транзакций выполняет критически значимые операции, то, возможно, имеет смысл только их выполнять в синхронном режиме.
Уровни журнала предзаписи
Основным назначением журнала предзаписи является восстановление согласованности после сбоя.
Однако механизм журналирования также используется и для других задач, таких как резервное копирование и репликация.
Для решения указанных задач в журнале должна сохраняться некоторая дополнительная информация.
Уровень журнала, задаваемый конфигурационным параметром wal_level, определяет перечень журналируемой информации, необходимой для решения тех или иных задач.
Каждый следующий уровень включает в себя информацию из перечня предыдущего уровня и добавляет некоторую новую информацию.
Всего предусмотрено три уровня:
minimalreplica(по умолчанию)logical
Уровень minimal
На данном уровне журналируется минимальный объем информации, достаточный для восстановления согласованности после сбоя.
В частности, на уровне minimal не журналируются операции массовой вставки данных, такие как CREATE INDEX или CREATE TABLE AS SELECT.
Долговечность данных в этом случае гарантируется самими операциями. Грязные страницы сразу сбрасываются на накопители.
Уровень replica
Уровень replica позволяет использовать журнал для физической репликации данных на другой сервер, а также при восстановлении из физических резервных копий.
На данном уровне, в дополнение к перечню информации уровня minimal, журналируются операции массовой вставки, а также информация об исключительных блокировках и статусах транзакций.
Процедура физической репликации, как и восстановления из физической резервной копии, предполагает использование базовой резервной копии с применением к ней потока журнальных записей.
Если операции массовой вставки были выполнены после создания базовой резервной копии, то они должны журналироваться, чтобы их результат не был потерян.
Для репликации также требуется информация об исключительных блокировках, поскольку они могут быть несовместимы с блокировками выполняющихся на реплике запросов, а также информация об активных транзакциях для построения снимков данных на реплике.
Более подробно процедуры репликации и резервного копирования будут рассмотрены в курсе DBA3.
Уровень logical
Уровень logical является максимальным и позволяет использовать журнал для организации логической репликации.
При физической репликации в виде журнальных записей передаются изменения страниц данных без наличия информации о смысле совершенных при этом операций.
Логическая же репликация требует понимания смысла выполненных изменений, поскольку данный вид репликации является платформонезависимым. Информация о смысле изменений как раз и записывается в журнал.
Уровень logical в этом случае должен быть установлен на публикующем сервере.
Проблема неатомарности записи
Размер страницы данных в Pangolin составляет 8 kB.
Однако запись данных на энергонезависимые накопители, как правило, происходит блоками меньшего размера (например, 4 kB).
В случае если сбой произойдет во время записи, может оказаться так, что половина страницы была успешно записана, а вторая — нет.
Указанная проблема называется неатомарной записью или torn page.
Очевидно, что применение к такой странице журнальных записей при восстановлении не поможет.
Для решения данной проблемы в журнальной записи предусмотрена возможность хранения полного образа страницы (Full Page Image, FPI).
За настройку хранения FPI отвечает параметр full_page_writes (по умолчанию включен).
Если этот параметр включен, то FPI будет записываться в журнал при каждом первом изменении страницы после выполнения контрольной точки (то есть сброса накопившихся грязных страниц на накопитель). О контрольной точке вы узнаете в следующей лекции.
Далее, если при восстановлении в журнале встречается FPI, то соответствующая страница заменяется указанным FPI, поскольку полный образ страницы, как и вся журнальная запись, защищен контрольной суммой.
Сохранение полных образов страниц решает проблему неатомарности записи, однако существенно увеличивает объем журнала.
В то же время имеется возможность сжатия FPI в журнале с использованием параметра конфигурации wal_compression (по умолчанию выключен). Поддерживаются методы сжатия pglz, lz4 и zstd.
Итоги
Подведем итоги задания:
- Журнал предзаписи обеспечивает свойство долговечности транзакций
- Журнал может записываться в синхронном и асинхронном режимах
- Журнал также используется для резервного копирования и репликации
- С помощью журнала может быть решена проблема неатомарности записи страниц
Самопроверка
Вопрос 1
Какие действия журналируются в WAL? Выберите все верные варианты ответа:
Вопрос 2
Какие конфигурационные параметры отвечают за настройку асинхронного режима записи журнала WAL? Выберите все верные варианты ответа:
Вопрос 3
Для каких целей может использоваться журнал с уровнем replica? Выберите все верные варианты ответа:
Вопрос 4
С какой целью с использованием параметра full_page_writes может быть настроена запись в журнал полных образов страниц (FPI)?