Уровень 2.0
Предусловие:
- Изучен модуль «Журнал предзаписи» данного курса
В этом задании вы научитесь работать с:
- Контрольной точкой
- Восстановлением после сбоя
- Настройкой контрольной точки и объема журнала WAL
- Процессом фоновой записи
- Мониторингом
Запись грязных страниц. Контрольная точка
Понятие и назначение контрольной точки
Как теперь известно, данные в оперативной памяти защищены от потери журналом предзаписи.
Каждое изменение в кеше буферов или журнале CLOG сопровождается сохранением журнальной записи в сегменте WAL.
При этом работа с кешем буферов происходит таким образом, что активно используемые страницы не вытесняются из него, в том числе при их изменениях.
Теоретически такие страницы могут никогда не вытесняться из кеша обслуживающими процессами.
Для защиты от потери данных в таком случае необходимо вести журнал на протяжении всей их долгой жизни, бесконечно увеличивая размер журнала и время восстановления после сбоя.
С целью предотвращения разрастания журнала предзаписи в Pangolin применяется процедура под названием контрольная точка, выполняемая специальным фоновым процессом checkpointer или вручную командой CHECKPOINT.
Процесс checkpointer с периодичностью, заданной параметром checkpoint_timeout, сбрасывает грязные страницы на накопители и удаляет ставшие ненужными сегменты WAL. По умолчанию контрольная точка выполняется раз в 5 минут.
Процесс записи страниц в файлы данных является дорогостоящим, поскольку связан с операциями ввода/вывода.
Поэтому для снижения влияния на производительность системы процесс контрольной точки растягивается во времени.
Если быть более точным, его выполнение планируется таким образом, чтобы сброс страниц занимал checkpoint_completion_target от времени между контрольными точками. По умолчанию значение данного параметра равняется 0.9.
Таким образом, хотя в названии процесса и присутствует термин «точка», в действительности процесс представляет собой временной отрезок.
Этапы контрольной точки
Контрольная точка выполняется в несколько этапов.
Сначала сбрасываются страницы из кешей малого размера, таких как кеш журнала CLOG или кеш вложенных транзакций. Далее выполняется запись грязных страниц из кеша буферов. При этом сначала все грязные буферы в кеше буферов помечаются как необходимые для сброса в процессе контрольной точки.
Затем процесс последовательно записывает страницы с отмеченных буферов в файлы данных. При этом вытеснение страниц не происходит, поэтому значения параметров usage count и pin count не учитываются.
Во время этого процесса могут образовываться новые грязные страницы в кеше, но, поскольку они не были отмечены в рамках текущей контрольной точки, они не будут сброшены на накопители.
Помимо этого, страница в отмеченном буфере может быть сброшена на накопитель раньше, чем до нее доберется процесс контрольной точки. Это может произойти при ее вытеснении обслуживающим процессом. В этом случае обслуживающий процесс снимет отметку о необходимости записи в заголовке буфера и контрольная точка ее пропустит.
На последнем этапе, когда все грязные страницы сброшены на накопитель, в журнал WAL добавляется запись о завершении контрольной точки (запись типа CHECKPOINT_ONLINE) с указанием LSN ее начала.
Помимо этого, в файле pg_control в каталоге global каталога данных указывается LSN журнальной записи о пройденной контрольной точке и LSN, соответствующий ее началу. Это делается для того, чтобы быстро определить момент, с которого необходимо проиграть журнальные записи при восстановлении.
Восстановление после сбоя
После сбоя для восстановления согласованности данных никаких дополнительных действий, помимо запуска экземпляра, совершать не требуется.
Запуск экземпляра начинается с процесса postmaster (postgres), который, в свою очередь, запускает процесс startup.
Процесс startup обращается к файлу pg_control с целью проверки статуса кластера баз данных (поле Database cluster state).
Если статус in production (в работе), то процесс startup понимает, что произошел сбой, поскольку экземпляр еще не запущен.
Тогда он начинает процедуру восстановления, проигрывая записи WAL с начала последней пройденной контрольной точки, LSN которого также указан в файле pg_control.
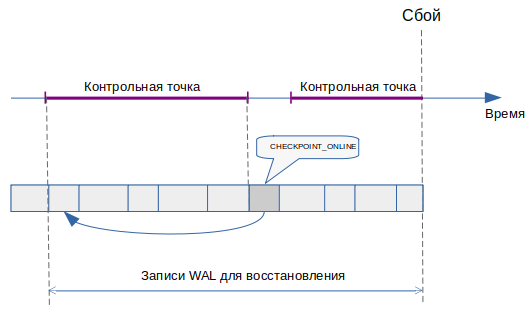
На рисунке выше сбой произошел во время выполнения второй контрольной точки. Поэтому для восстановления необходимы записи WAL с начала первой контрольной точки, которая является последней завершенной на момент сбоя.
Момент завершения указанной контрольной точки зафиксирован в журнале записью с типом CHECKPOINT_ONLINE, в которой указан LSN, соответствующий началу контрольной точки.
Восстановление происходит путем последовательного применения записей WAL, поскольку каждое следующее состояние страницы зависит от предыдущего.
При этом вспомним, что в заголовке страницы хранится LSN записи, следующей за записью, сформированной при последнем изменении страницы.
Исходя из этого, содержимое записи WAL применяется к соответствующей странице, если LSN в ее заголовке меньше или равен LSN записи WAL.
Если LSN страницы оказался больше LSN записи, то это означает, что страница была сброшена на накопитель позже, чем сформирована текущая журнальная запись, и применять ее к данной странице нельзя.
Однако из этого правила есть исключение. Если в записи WAL имеется полный образ страницы (FPI), то страница им перезаписывается, не обращая внимания на LSN, поскольку к FPI больше доверия (FPI, как и все журнальные записи, защищен контрольной суммой, а страницы данных необязательно ею защищены) и в журнале имеются все необходимые записи для восстановления актуального состояния страницы.
Состояние страницы в этом случае не имеет значения, поскольку она целиком перезаписывается.
Также безусловно перезаписываются статусы транзакций журнала CLOG, поскольку установка нового статуса транзакции никак не зависит от ее предыдущего статуса.
Поэтому в страницах журнала CLOG LSN соответствующих записей WAL не хранятся (вспомним, что они хранятся отдельно, в оперативной памяти, для соблюдения порядка сброса: сначала запись WAL, потом страница CLOG).
Помимо этого, журнальные записи применяются для операций с файлами и каталогами. Если в записи WAL имеется информация о создании файла, а в действительности его нет, то при восстановлении он будет создан.
В последнюю очередь перезаписываются нежурналируемые таблицы пустыми init-файлами.
Применение записей WAL к страницам происходит в кеше буферов. Поэтому в конце восстановления выполняется контрольная точка для сброса восстановленных страниц в энергонезависимые накопители.
Настройка контрольной точки и объема журнала
Объем журнала предзаписи зависит от частоты выполнения контрольных точек.
Чем чаще выполняются контрольные точки, тем меньший объем журнала WAL в среднем необходимо хранить. Однако тем больше будут накладные расходы, особенно в условиях активного изменения одних и тех же страниц данных.
Поэтому обычно рекомендуется определить допустимый объем журнала WAL.
При этом для восстановления после сбоя могут потребоваться записи, сгенерированные с момента начала последней завершенной контрольной точки до момента начала следующей контрольной точки, а также записи, сгенерированные с момента начала следующей контрольной точки до момента сбоя.
В результате допустимый объем WAL может быть определен следующим выражением:
allowed_vol = checkpoint_vol + checkpoint_vol x checkpoint_completion_target,
где:
allowed_vol— допустимый объем WALcheckpoint_vol— объем WAL, генерируемый между контрольными точками
Задав допустимый объем WAL, можно определить объем WAL, генерируемый между контрольными точками:
checkpoint_vol = allowed_vol / (1 + checkpoint_completion_target)
Далее можно провести замеры, за какое время этот объем (checkpoint_vol) накапливается при средней нагрузке.
Это можно сделать, фиксируя позицию вставки функцией pg_current_wal_insert_lsn в разные моменты времени и определяя объем накопленных записей WAL путем вычитания зафиксированных значений.
Определенное таким образом время в первом приближении может использоваться в качестве значения параметра checkpoint_timeout, определяющего периодичность срабатывания контрольной точки.
Однако нагрузка в системе не всегда бывает равномерной, и в период повышенной нагрузки за выбранное время может быть сгенерирован недопустимо большой объем журнальных записей.
Для предотвращения таких ситуаций имеется параметр max_wal_size, задающий объем журнала WAL, при достижении которого срабатывает внеплановая контрольная точка.
Как было сказано выше, сброс грязных страниц в ходе контрольной точки растягивается во времени. Это делается таким образом, чтобы контрольная точка была завершена через время, равное
checkpoint_timeout x checkpoint_completion_target.
Если контрольная точка выполняется быстрее, чем ожидалось, то ее выполнение замедляется путем увеличения паузы между сбросами грязных страниц.
И наоборот, если скорость выполнения контрольной точки оказывается недостаточной для завершения за время
checkpoint_timeout x checkpoint_completion_target, то паузы между сбросами сокращаются.
Аналогично регулируется скорость выполнения контрольной точки при приближении объема WAL к значению max_wal_size.
Значение по умолчанию checkpoint_completion_target выбрано достаточно большим (0.9) для растягивания выполнения контрольной точки практически до времени checkpoint_timeout, при этом оставляя небольшой временной запас на случай возникновения издержек при завершении процедуры контрольной точки.
После окончания контрольной точки журнальные записи, созданные до момента ее начала, могут быть удалены.
Однако часть таких записей не удаляется, среди них:
- записи, не прочитанные через слот репликации
- записи, не записанные в архив при непрерывной архивации
- записи, не превышающие объем
wal_keep_size - записи, не превышающие объем
wal_min_size
Как уже было сказано, журнал может использоваться не только для восстановления после сбоя.
Поэтому также нельзя удалять записи, необходимые для физической репликации и резервного копирования.
Для этого могут использоваться различные механизмы сохранения записей WAL, среди которых использование слота репликации и непрерывной архивации.
Помимо этого, просто можно удерживать некоторый минимальный объем журнальных записей путем настройки параметра wal_keep_size.
Также для экономии ресурсов на пересоздании файлов журнала используется параметр min_wal_size, задающий минимальный неудаляемый объем журнальных записей.
Файлы, включенные в этот объем, не удаляются, а переименовываются и используются заново. Этот параметр имеет значение, только когда включен режим переиспользования параметром wal_recycle.
Однако для файловых систем с поддержкой copy-on-write быстрее создавать новые файлы, поэтому для них такой режим неэффективен.
Процесс фоновой записи
Как было сказано выше, контрольная точка обычно выполняется по расписанию, неторопливо сбрасывая грязные страницы на накопители.
Поэтому обслуживающие процессы также иногда вынуждены сбрасывать грязные страницы при их вытеснении (подробнее в задании «Кеш буферов» курса DBA2). Такие ситуации являются не очень хорошими, поскольку могут значительно замедлять выполнение запросов.
Для уменьшения количества таких ситуаций в Pangolin имеется третий процесс, обеспечивающий сброс грязных страниц на накопители. Его название backgroud writer или процесс фоновой записи.
Процесс фоновой записи осуществляет поиск буферов для записи способом, похожим на тот, который применяется алгоритмом вытеснения.
Используя свой указатель, алгоритм фоновой записи последовательно перебирает буферы с целью обнаружения и записи буферов, удовлетворяющих следующим условиям:
- является грязным
- не закреплен (
pin count= 0) - не использовался (
usage count= 0)
Алгоритм фоновой записи идет немного впереди алгоритма вытеснения и записывает грязные страницы на накопители раньше, чем до них доберется алгоритм вытеснения.
Тем самым снижается вероятность того, что при вытеснении обслуживающему процессу придется выполнять сброс грязной страницы на накопитель.
Процесс фоновой записи чередует работу и ожидание. Время ожидания задается параметром bgwriter_delay (по умолчанию 200 ms).
За время работы процесс сбрасывает не более bgwriter_lru_maxpages грязных страниц (по умолчанию 100).
Точное количество страниц для сброса вычисляется на основе скользящего среднего количества буферов, запрошенного обслуживающими процессами с момента предыдущего запуска.
Вычисленное количество увеличивается путем домножения на коэффициент bgwriter_lru_multiplier (по умолчанию 2), но не может превосходить значение bgwriter_lru_maxpages.
Мониторинг
Мониторинг записи грязных буферов может обеспечить выявление следующих проблем:
- нарушение расписания выполнения контрольных точек
- частая запись грязных страниц обслуживающими процессами при вытеснении
Во-первых, в журнал сообщений выводится предупреждение, в случае если выполнение контрольных точек по причине превышения журналом WAL объема max_wal_size происходит чаще, чем определено в параметре checkpoint_warning (по умолчанию 30 sec).
Если такие предупреждения в журнале сообщений появляются часто, то, возможно, необходимо увеличить частоту срабатываний контрольных точек checkpoint_timeout или значение параметра max_wal_size.
Во-вторых, по умолчанию в журнал сообщений выводится информация о каждой выполненной контрольной точке. Отключить вывод таких сообщений можно использованием параметра log_checkouts.
И наконец, статистику записи грязных буферов различными процессами можно посмотреть с помощью представления pg_stat_bgwriter, например:
wal_db=# SELECT * FROM pg_stat_bgwriter\gx
-[ RECORD 1 ]---------+------------------------------
checkpoints_timed     | 1468
checkpoints_req       | 6
checkpoint_write_time | 619861
checkpoint_sync_time  | 133
buffers_checkpoint    | 6997
buffers_clean         | 0
maxwritten_clean      | 0
buffers_backend       | 3257
buffers_backend_fsync | 0
buffers_alloc         | 8033
stats_reset           | 2025-08-14 15:23:54.772261+03
Наиболее интересная информация хранится в следующих полях указанного представления:
checkpoints_timed— количество контрольных точек, выполненных по расписаниюcheckpoints_req— количество контрольных точек, выполненных вручную или при превышении значенияmax_wal_sizebuffers_checkpoint— количество страниц, сброшенных на накопители процессомcheckpointerbuffers_clean— количество страниц, сброшенных на накопители процессом фоновой записиbuffers_backend— количество страниц, сброшенных на накопители обслуживающими процессами при вытеснении
Большое значение checkpoints_req свидетельствует о нарушении расписания выполнения контрольных точек.
Значение buffers_backend должно быть кратно (если не на порядки) меньше суммы значений buffers_checkpoint и buffers_clean.
Если это не так, то, значит, процессы контрольной точки и фоновой записи не справляются с интенсивностью порождения грязных страниц, и обслуживающим процессам приходится самим их сбрасывать при вытеснении.
Однако необходимо отметить, что в поле buffers_backend, несмотря на его название, учитываются записи грязных страниц не только обслуживающими процессами, но и некоторыми другими, например процессом автоочистки.
Итоги
- Контрольная точка необходима для ограничения размера журнала WAL
- Настройка контрольных точек — это баланс между допустимым объемом журнала WAL и накладными расходами при их выполнении
- Процесс фоновой записи необходим для снижения вероятности записи грязных страниц обслуживающими процессами
- Мониторинг записи грязных страниц выполняется с использованием представления
pg_stat_bgwriter
Самопроверка
Вопрос 1
С какого момента необходимы журнальные записи для восстановления согласованности после сбоя?
Вопрос 2
Какой параметр определяет критерий внепланового срабатывания контрольной точки?
Вопрос 3
Какие условия необходимы для того, чтобы процесс фоновой записи, перейдя на очередной буфер, вытеснил страницу из него? Выберите все верные варианты ответа: