Уровень 2.0
Предусловие:
- Изучен модуль «Снимки данных» данного курса
В этом задании вы узнаете:
- Общие сведения об очистке и сопутствующих задачах
- Об устройстве автоочистки
- Про этапы и скорость очистки
- О мониторинге и настройке автоочистки
Общие сведения об очистке и сопутствующих задачах
Механизм MVCC является эффективным с точки зрения производительности при параллельном выполнении транзакций.
Однако, как уже известно, при его работе накапливаются устаревшие версии строк, которые не нужны ни одной из активных транзакций, то есть находятся за горизонтом очистки. Такие версии строк называются «мертвыми», и их необходимо каким-то образом удалять, предотвращая разрастание базы данных.
Процедура очистки
Для этого в Pangolin предусмотрена встроенная процедура очистки.
Очистка выполняется в фоновом режиме и не блокирует работу операторов DML. В то же время очистка блокирует работу операторов DDL, связанных с изменением таблиц, таких как ALTER TABLE и CREATE INDEX.
В ходе очистки из табличных страниц удаляются устаревшие версии строк, а из индексных страниц — ссылающиеся на них индексные строки. Указатели на удаленные строки при этом освобождаются.
Освободившееся на странице пространство не возвращается операционной системе, а используется в дальнейшем для вставки новых версий строк.
Очистке подвергаются таблицы с индексами, TOAST-таблицы и материализованные представления.
Автоматическая очистка
В стандартном сценарии очистка выполняется в автоматическом режиме, адаптируясь под интенсивность изменений в базах данных или, по-другому, под скорость возникновения «мертвых» версий строк.
За автоочистку в Pangolin отвечает группа процессов под общим названием autovacuum.
Для работы автоочистки требуется установка двух параметров:
autovacuum = ontrack_counts = on
Помимо установки в значение on параметра autovacuum также требуется установка в значение on параметра track_counts, отвечающего за сбор статистики активности использования баз данных.
Поскольку автоочистка подстраивается под интенсивность изменений в базах данных, для ее работы требуется статистическая информация об этом.
Ручная очистка
Кроме того, при необходимости очистка может запускаться в ручном режиме.
Для этого может использоваться SQL-команда VACUUM или утилита vacuumdb, являющаяся оберткой над командой VACUUM.
Команде VACUUM в качестве параметра можно передать список таблиц, подлежащих очистке. Без указания такого списка будут очищены все таблицы и материализованные представления при наличии соответствующих прав у пользователя.
Полная очистка
Однако в случае необходимости очистка может быть выполнена путем физического перестроения всех таблиц и индексов с высвобождением дискового пространства.
Для этого используются следующие команды:
VACUUM FULL— полная очистка «мертвых» версий строк с перестроением таблицы и ее индексовCLUSTER— выполняет те же действия, что иVACUUM FULL, а также физическое переупорядочивание версий строк в соответствии с одним из индексов. Переупорядочение необходимо для повышения эффективности индексного доступаREINDEX— перестроение только индексовTRUNCATE— очистка таблицы от всех версий строк (фактически создается новый пустой файл)
Необходимо иметь ввиду, что указанные команды требуют исключительной блокировки объектов, с которыми работают.
Сопутствующие задачи обслуживания MVCC
Помимо непосредственно удаления «мертвых» строк в ходе очистки также выполняется ряд операций, необходимых для функционирования механизма MVCC, среди которых:
- Обновление карты видимости
- Обновление карты свободного пространства
- Заморозка версий транзакций
Напомним, что в карте видимости отмечены страницы, в которых все версии строк являются актуальными и видны во всех снимках. Таким образом, во время очистки не требуется просматривать страницы, отмеченные в карте видимости, поскольку в них нет «мертвых» строк.
Помимо этого, карта видимости необходима для повышения эффективности метода доступа под названием сканирование только индекса (Index Only Scan), который выбирается планировщиком при наличии всех запрашиваемых данных в индексе. В этом случае, если табличная страница отмечена в карте видимости, нет необходимости обращения к ней для определения видимости версий строк в снимке.
В свою очередь, в карте свободного пространства отмечено доступное свободное место для каждой страницы (как табличной, так и индексной). Карта свободного пространства применяется для поиска подходящих страниц при вставке новых версий строк.
Также, с целью предотвращения разрастания каталогов, в которых хранятся статусы транзакций (pg_xact) и мультитранзакций (pg_multixact), при очистке выполняется заморозка версий строк, созданных старыми транзакциями.
Подробнее о заморозке речь пойдет в лекции «Заморозка версий строк».
Обновление статистики планировщика
Помимо задач обслуживания механизма MVCC в ходе очистки также обычно выполняется обновление статистики для планировщика.
Под обновлением статистики понимается сбор информации о распределении данных в отношениях, в том числе:
- Количество строк в отношениях
- Количество страниц в отношениях
- Число уникальных значений в столбцах
- Наиболее частые значения в столбцах
Своевременное обновление статистики крайне важно для построения адекватных планов запроса.
Поэтому указанная задача попутно выполняется в ходе автоматической очистки.
Также обновление статистики может быть явно вызвано командой ANALYZE или VACUUM ANALYZE — для совмещения с ручной очисткой. Обновление статистики проводится для таблиц и материализованных представлений. Сбор статистики для TOAST-таблиц не требуется, поскольку к ним возможен только индексный доступ.
Устройство автоочистки
За работу автоочистки в Pangolin отвечают следующие процессы:
autovacuum launcherautovacuum worker
Процесс autovacuum launcher планирует запуск процессов autovacuum worker, которые непосредственно занимаются очисткой баз данных.
Процесс autovacuum launcher постоянно запущен при включенном конфигурационном параметре autovacuum.
Частота запуска процессов autovacuum worker определяется конфигурационным параметром autovacuum_naptime (по умолчанию 60 секунд).
Если баз данных в кластере N, то процесс autovacuum launcher просыпается каждые autovacuum_naptime/N единиц времени и запускает (точнее, дает команду о запуске процессу postmaster) один процесс autovacuum worker с указанием ему одной базы данных для очистки.
Однако если для очистки базы данных процессу autovacuum worker времени autovacuum_naptime не хватило, то ему в помощь autovacuum launcher запускает еще один рабочий процесс.
Общее количество процессов autovacuum worker ограничено конфигурационным параметром autovacuum_max_workers (по умолчанию 3).
Каждый процесс autovacuum worker для своей базы данных составляет два списка:
- Список таблиц, TOAST-таблиц и материализованных представлений, которым нужна очистка
- Список таблиц и материализованных представлений, требующих обновления статистики для планировщика (анализа)
В указанные списки не попадают таблицы с выключенными параметрами хранения autovacuum_enabled и toast.autovacuum_enabled.
Выключением параметра autovacuum_enabled можно запретить выполнять авточистку для конкретной таблицы.
В свою очередь, выключением параметра toast.autovacuum_enabled запрещается автоочистка TOAST-таблицы для заданной таблицы. Параметр toast.autovacuum_enabled перекрывает значение параметра autovacuum_enabled.
Значения указанных параметров не учитываются в случае необходимости проведения «агрессивной» заморозки для предотвращения зацикливания счетчика транзакций (см. лекцию «Заморозка версий строк»).
При включенных параметрах autovacuum_enabled и toast.autovacuum_enabled необходимость очистки и анализа таблиц определяется на основе критериев, рассмотренных ниже.
Построение списка таблиц для очистки
Для определения необходимости проведения очистки таблицы используется следующая информация:
- Число «мертвых» версий строк в таблице и их допустимая доля в таблице
- Число вставленных строк с момента последней очистки и их допустимая доля в таблице
Число «мертвых» версий строк
Число «мертвых» версий строк в таблице определяется полем n_dead_tup системного представления pg_stat_all_tables.
Допустимая доля «мертвых» строк в таблице определяется конфигурационным параметром autovacuum_vacuum_scale_factor.
Общее число актуальных строк в таблице записывается в поле reltuples таблицы pg_class.
Также на критерий необходимости очистки влияет конфигурационный параметр autovacuum_vacuum_threshold, определяющий минимальный абсолютный порог «мертвых» версий строк.
В итоге критерий необходимости очистки таблицы по числу «мертвых» строк выглядит следующим образом:
pg_stat_all_tables.n_dead_tup > autovacuum_vacuum_threshold + autovacuum_vacuum_scale_factor x pg_class.reltuples
В этой формуле определяющим параметром является autovacuum_vacuum_scale_factor. Его значение по умолчанию равняется 0.2, что означает, что таблица будет очищаться только когда число «мертвых» строк в ней достигнет 20 %.
Это значение на практике, как правило, уменьшается для исключения разрастания таблиц.
Помимо этого указанные параметры могут задаваться также на уровне отдельных таблиц. Для этого используются соответствующие параметры хранения:
autovacuum_vacuum_thresholdиtoast.autovacuum_vacuum_thresholdautovacuum_vacuum_scale_factorиtoast.autovacuum_vacuum_scale_factor
Число вставленных строк
Таблицы, в которых строки не изменяются, то есть не порождаются «мертвые» версии строк, под предыдущий критерий не подпадают.
Однако если в таких таблицах активно осуществляется вставка строк, то их также необходимо подвергать процедуре очистки для выполнения вспомогательных задач, таких как обновление карты видимости и заморозка версий строк.
Для этой цели есть аналогичный критерий, использующий похожие конфигурационные параметры:
pg_stat_all_tables.n_mod_since_analyze > autovacuum_analyze_threshold + autovacuum_analyze_scale_factor * pg_class.reltuples.
Здесь
pg_stat_all_tables.n_ins_since_vacuum— число строк, вставленных с момента последней очисткиautovacuum_vacuum_insert_threshold— минимальный абсолютный порог вставленных строкautovacuum_vacuum_insert_scale_factor— допустимая доля вставленных строк с момента последней очистки
Также имеются соответствующие параметры хранения таблиц:
autovacuum_vacuum_insert_thresholdиtoast.autovacuum_vacuum_insert_thresholdautovacuum_vacuum_insert_scale_factorиtoast.autovacuum_vacuum_insert_scale_factor
Построение списка таблиц для анализа
Построение списка таблиц для анализа выполняется по аналогии с построением списка таблиц для очистки.
Однако в случае с анализом можно не разделять измененные, удаленные и вставленные строки, так как и те и другие требуют проведения одной и той же процедуры обновления статистики.
Необходимость проведения анализа таблицы определяется следующим критерием:
pg_stat_all_tables.n_mod_since_analyze > autovacuum_analyze_threshold + autovacuum_analyze_scale_factor x pg_class.reltuples.
Здесь
pg_stat_all_tables.n_mod_since_analyze— число строк, измененных (включая удаленные и вставленные) с момента последней очисткиautovacuum_analyze_threshold— минимальный абсолютный порог измененных строкautovacuum_analyze_scale_factor— допустимая доля измененных строк с момента последней очистки
Также имеются соответствующие параметры хранения таблиц:
autovacuum_vacuum_analyze_thresholdautovacuum_vacuum_analyze_scaleindex_vacuum_count
Для TOAST-таблиц анализ не проводится, поэтому соответствующие параметры хранения не предусмотрены.
Этапы очистки
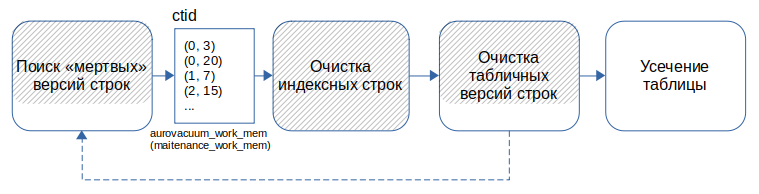
Как уже было сказано, в процессе очистки из таблицы должны быть удалены «мертвые» версии строк, из всех индексов — ссылающиеся на них индексные строки, а также должны быть освобождены соответствующие указатели.
Проблема в том, что в индексах нет информации об актуальности индексных строк. Указанная информация может быть получена из табличных версий строк. Следовательно, сначала необходимо просканировать табличные страницы в поисках «мертвых» версий строк.
К сожалению, на этом этапе удалять найденные «мертвые» версии из табличных страниц нельзя, поскольку на них по-прежнему имеются ссылки в индексных строках.
Поэтому на первом этапе при сканировании табличных страниц составляется лишь список идентификаторов версий строк (ctid), подлежащих очистке.
Далее, на втором этапе, в соответствии с составленным списком вычищаются индексные строки.
А уже на третьем этапе при повторном сканировании табличных страниц удаляются непосредственно «мертвые» версии строк.
На последнем этапе происходит усечение таблиц. Если в результате очистки образовалось относительно много пустых страниц в конце файла, то они физически удаляются с высвобождением места операционной системе.
Рассмотрим подробнее указанные этапы.
Поиск «мертвых» версий строк
На первом этапе осуществляется сканирование табличных страниц с целью определения ctid версий строк, находящихся за горизонтом очистки.
При сканировании пропускаются страницы, отмеченные в карте видимости.
Параметры ctid найденных версий строк запоминаются в локальной памяти процесса.
Предельный размер выделяемой памяти определяется параметром maintenance_work_mem для ручной очистки и параметром autovacuum_work_mem для автоматической очистки.
В PostgreSQL значение параметра maintenance_work_mem по умолчанию равно 64 MB, в то время как autovacuum_work_mem = -1, что означает необходимость использования значения maintenance_work_mem.
Однако в Pangolin значения по умолчанию изменены:
maintenance_work_mem= 1/48 от объема памяти сервераautovacuum_work_mem= 1/24 от объема памяти сервера
При ручной очистке память выделяется по мере необходимости, при автоматической — вся сразу.
Необходимо учитывать, что при автоматической очистке сканирование таблиц выполняется параллельно несколькими рабочими процессами, под каждый выделяется память размером autovacuum_work_mem.
При большом количестве рабочих процессов может потребоваться переопределить значение параметра autovacuum_work_mem.
В случае, если память для найденных ctid заканчивается, сканирование таблицы прерывается и осуществляется переход на следующий этап.
Очистка индексных строк
На втором этапе происходит сканирование всех индексов, связанных с таблицей, с целью поиска и очистки индексных строк в соответствии с составленным списком ctid.
Индексы при этом сканируются полностью, так как не существует другого способа обнаружения индексной строки по идентификатору версии строки ctid.
При ручной очистке сканирование индексов может выполняться несколькими рабочими процессами, общее количество которых ограничено параметром max_parallel_maintenance_workers. Помимо этого количество процессов может быть ограничено вызовом команды VACUUM с использованием параметра PARALLEL, например VACUUM (PARALLEL 3).
Каждый индекс в этом случае сканируется одним рабочим процессом, параллельное сканирование одного индекса несколькими процессами не выполняется.
В автоматической же очистке не предусмотрено параллельного сканирования индексов, поскольку распараллеливание в этом случае осуществляется на уровне таблиц.
В ходе очистки индексов для соответствующих страниц также обновляется карта свободного пространства.
Очистка «мертвых» версий строк
После очистки индексов «мертвые» версии строк также могут быть безопасно удалены.
Для этого повторно читаются необходимые табличные страницы и удаляются версии строк в соответствии со списком ctid.
Помимо этого в начале страниц высвобождаются указатели на удаленные версии строк, а именно выставляется статус unused взамен normal.
Попутно обновляются карта видимости и карта свободного пространства.
Если при первом сканировании таблицы памяти для списка ctid оказалось недостаточно, то после удаления версий строк указанный список очищается и пройденные этапы повторяются начиная с того места, где произошло прерывание.
Таким образом, при недостаточном значении параметра autovacuum_work_mem (maintenance_work_mem) для очистки может потребоваться несколько проходов.
При этом сканирование индексов выполняется всегда заново в полном объеме, создавая избыточную нагрузку на СУБД.
Усечение таблицы
На последнем этапе, если образовалось достаточно много пустых страниц в конце файла таблицы, происходит их физическое удаление с высвобождением места операционной системе.
Усечение таблиц требует кратковременной исключительной блокировки на таблицу.
Однако этот этап можно исключить, используя параметры хранения vacuum_truncate и toast.vacuum_truncate для таблиц и TOAST-таблиц соответственно.
Помимо этого при ручной очистке усечение таблиц можно выключить командой VACUUM (TRUNCATE off).
Скорость очистки
Как было сказано выше, очистка работает на фоне и не блокирует работу операторов DML.
Тем не менее процесс очистки создает определенную нагрузку на СУБД, влияя на ее производительность.
Для снижения эффекта от создаваемой нагрузки процесс очистки можно растянуть во времени с периодической приостановкой его работы.
Для этого имеются соответствующие конфигурационные параметры autovacuum_vacuum_threshold:
| Параметры ручной очистки | Параметр автоочистки | Описание |
|---|---|---|
vacuum_cost_limit (200) | autovacuum_vacuum_cost_limit (-1) | Объем непрерывной работы в условных единицах |
vacuum_cost_delay (0 ms) | autovacuum_vacuum_cost_delay (2 ms) | Время простоя между этапами работы |
Для ручной очистки параметры по умолчанию не имеют значений. vacuum_cost_delay = 0 ms означает, что пауз в работе очистки нет. Если администратор вручную запустил очистку, то, скорее всего, он рассчитывает, что она выполнится с максимальной скоростью.
Иначе настроена автоочистка. По умолчанию время простоя составляет 2 мс между порциями работы объемом 200 условных единиц.
В свою очередь, объем работы определяется стоимостью обработки страниц в кеше буферов, которая задается следующими конфигурационными параметрами, не зависящими от способа запуска очистки (вручную или автоматически):
| Параметры ручной очистки | Описание |
|---|---|
vacuum_cost_page_hit (1) | Стоимость чтения страницы из кеша буферов |
vacuum_cost_page_miss (2) | Стоимость чтения страницы с энергонезависимого хранилища |
vacuum_cost_page_dirty (20) | Стоимость, если в результате очистки чистая страница стала грязной |
Важно учитывать, что значение параметра autovacuum_vacuum_cost_limit определяет общий объем работы всех рабочих процессов.
Поэтому для ускорения автоочистки путем ее распараллеливания недостаточно увеличить количество рабочих процессов в параметре autovacuum_max_workers.
Также необходимо пропорционально увеличить значение параметра autovacuum_vacuum_cost_limit.
Мониторинг и настройка автоочистки
Подводя итог, рассмотрим основные проблемы автоочистки, способы их выявления и устранения.
Разрастание базы данных
Автоочистка — адаптивный механизм. Чем выше интенсивность изменений в базе данных, тем чаще будет выполняться очистка ее объектов.
В то же время порог срабатывания очистки является настраиваемой величиной (параметры группы scale_factor и threshold).
Чем выше порог срабатывания, тем очистка/анализ будет выполняться реже и тем больше будет порция обрабатываемых данных.
Порог срабатывания также может быть настроен на уровне таблицы с использованием соответствующих параметров хранения.
С одной стороны, в таком случае будет меньше накладных расходов (меньше повторных чтений одних и тех страниц) и соответственно меньше нагрузка на СУБД, но с другой стороны, очистка может не успевать за интенсивностью изменений и база данных будет разрастаться.
В конечном итоге это может привести к необходимости перестроения таблиц и индексов командой VACUUM FULL или CLUSTER.
Отслеживать разрастание таблиц можно в том числе с использованием расширения pgstattuple, которое позволяет определить плотность данных в страницах.
Указанное расширение будет рассмотрено в лабораторной работе.
Повторное сканирование индексов
Помимо этого, при обработке большой порции данных требуется больше локальной памяти для хранения списка идентификаторов «мертвых» версий строк ctid.
В случае если список ctid «мертвых» версий строк целиком не поместится в выделенную память, будет выполняться повторное сканирование индексов.
Данную проблему можно решить либо уменьшением порога срабатывания, либо увеличением объема локальной памяти рабочего процесса автоочистки (параметр autovacuum_work_mem).
Отслеживается такая ситуация в процессе выполнения очистки с использованием системного представления pg_stat_progress_vacuum.
Повторное сканирование индексов можно определить по значению поля index_vacuum_count, которое не должно превышать 1.
Таким образом, настройка параметров порога срабатывания — это поиск баланса, при котором, с одной стороны, база данных не разрастается, а с другой стороны, автоочистка не создает существенной нагрузки на систему.
Недостаточная скорость очистки
Также при определенных настройках автоочистка может в принципе не справляться с порученным объемом работы. В таком случае будет накапливаться очередь из таблиц, подлежащих очистке/анализу.
Исправить такую ситуацию можно путем увеличения скорости выполнения очистки (параметры группы cost_limit и cost_delay), а также увеличением предельного количества рабочих процессов (параметр autovacuum_max_workers).
Помимо этого, причиной низкой скорости очистки может быть недостаточный размер кеша буферов (параметр shared_buffers).
Мониторинг очереди таблиц можно настроить с помощью информации из критерия необходимости очистки таблицы: pg_stat_all_tables.n_dead_tup > autovacuum_vacuum_threshold + autovacuum_vacuum_scale_factor * pg_class.reltuples
Представление для мониторинга очереди таблиц, построенное с использованием информации из указанного критерия, будет рассмотрено в лабораторной работе.
В то же время при низком пороге срабатывания автоочистки может потребоваться сгладить пиковые нагрузки на систему путем снижения скорости выполнения очистки.
Другие способы мониторинга
Мониторинг текущей работы очистки и автоочистки может осуществляться также с использованием представлений группы pg_stat_progress, а также в журнале сообщений, куда попадают сведения о действиях автоочистки, время которой превысило log_autovacuum_min_duration.
Итоги
- Автоочистка необходима для функционирования механизма MVCC
- В процессе очистки удаляются «мертвые» версии строк, обновляются карты видимости и свободного пространства, замораживаются старые версии строк, а также обновляется статистика для планировщика
- Плохо настроенная автоочистка может привести к разрастанию базы данных или чрезмерной нагрузке на систему
- Автоочистка настраивается множеством параметров, определяющих частоту и скорость ее выполнения
Самопроверка
Вопрос 1
К каким негативным последствиям может привести отключение автоочистки? Выберите все верные варианты ответа:
Вопрос 2
Какие из приведенных конфигурационных параметров могут оказывать влияние на частоту выполнения очистки таблиц группой процессов autovacuum? Выберите все верные варианты ответа:
Вопрос 3
Какие из приведенных SQL-команд перестраивают объекты базы данных с созданием новых файлов? Выберите все верные варианты ответа:
Вопрос 4
Какие действия выполняет команда VACUUM? Выберите все верные варианты ответа: