Уровень 2.0
Предусловие:
- Изучен модуль «Заморозка версий строк» данного курса
В этом задании вы узнаете:
- Назначение и структура кеша буферов
- Про операции с буферами в кеше
- О буферном кольце
- Про настройку кеша буферов
Кеш буферов
Назначение кеша буферов
Как известно, энергонезависимая память, к которой относятся, например, магнитные жесткие диски (HDD) или твердотельные накопители (SSD), обладает низкой скоростью ввода/вывода по сравнению с оперативной памятью.
В современных системах для компенсации разности скоростей различных типов памяти используются механизмы кеширования данных. Кеширование позволяет использовать быструю память для небольшого объема часто используемых данных, снижая число обращений к медленной памяти.
В Pangolin кеширование в оперативной памяти выполняется на двух уровнях:
- На уровне операционной системы
- На уровне СУБД
Pangolin, как и PostgreSQL, взаимодействует с энергонезависимой памятью не напрямую, а посредством кеша файловых операций в адресном пространстве операционной системы.
Использование промежуточного кеша на уровне операционной системы — это скорее недостаток, чем преимущество. Поэтому в настоящее время сообществом PostgreSQL ведутся работы по реализации прямого взаимодействия с энергонезависимой памятью.
В архитектуре Pangolin предусмотрено достаточно большое количество различных кешей как в разделяемой, так и в локальной памяти процессов.
Наиболее значимым является кеш буферов, предназначенный для работы со страницами данных. Он обеспечивает быстрый доступ к часто используемым («горячим») страницам данных, снижая необходимость обращений к медленному энергонезависимому хранилищу.
Кеш буферов занимает большую часть разделяемой памяти и используется параллельно как обслуживающими (backend), так и фоновыми процессами, среди которых autovacuum, wal writer, checkpointer и background writer.
При этом необходимость последних трех из приведенных процессов обусловлена наличием самого кеша буферов. Указанные процессы будут рассмотрены в лекциях «Журнал предзаписи» и «Запись грязных страниц».
Структура кеша буферов
Кеш буферов представляет собой набор буферов, в каждом из которых зарезервировано место для одной страницы данных и заголовка буфера.
Помимо этого, в кеше буферов хранится хеш-таблица для обеспечения быстрого поиска страницы данных в кеше и два указателя: указатель на свободный буфер и указатель на следующую жертву, которые используются при поиске буфера для размещения новой страницы данных.
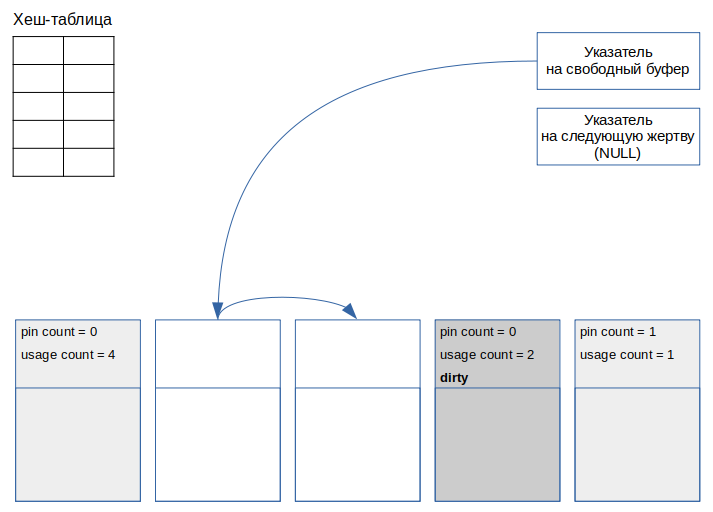
Заголовок буфера содержит информацию, достаточную для идентификации страницы данных, поиска, блокирования и вытеснения страницы из кеша. В том числе заголовок содержит следующую информацию:
-
идентификатор страницы, включающий:
- идентификатор файла отношения
- тип слоя: основной (
main), карта видимости (vm) или карта свободного пространства (fsm) - номер страницы в слое
-
флаг
dirty, являющийся признаком того, что данные на странице в буфере изменены и «грязная» страница должна быть записана в файл отношения -
счетчик
usage count— число обращений к странице в буфере (отражает эффективность нахождения страницы в кеше буферов) -
счетчик
pin count— число процессов, работающих с буфером в настоящий момент. Данный счетчик выступает признаком закрепления буфера
Использование хеш-таблицы, а также указателей на свободный буфер и следующую жертву при выполнении операций с буферами будет рассмотрено ниже.
Операции с буферами в кеше
Размещение страницы в свободном буфере
Изначально, при запуске экземпляра, кеш буферов пустой.
Указатель на свободный буфер ссылается на первый из них. В свою очередь, в заголовке свободного буфера имеется ссылка на следующий свободный буфер, а в нем — на следующий и т. д.
Таким образом, свободные буферы связаны в список, на первый элемент которого имеется ссылка в указателе.
При чтении страница из файла записывается в первый свободный буфер в списке.
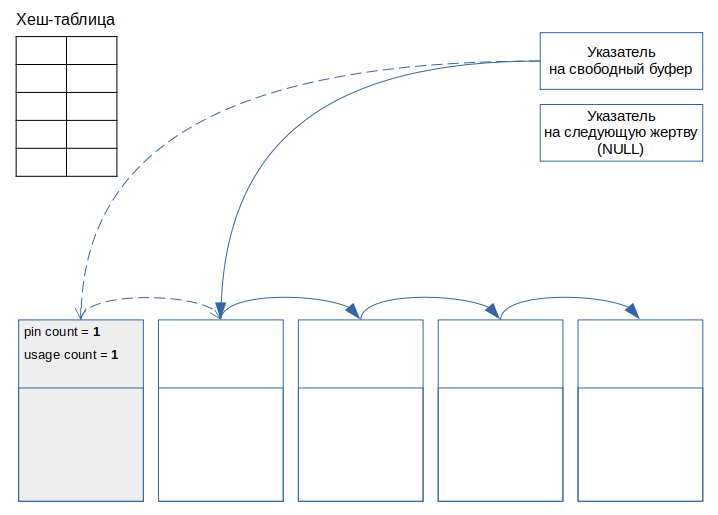
При этом страница закрепляется путем увеличения счетчика pin count.
Закрепление не позволит другим процессам ее удалить или заместить другой страницей во время работы с ней.
Однако при закреплении допускаются параллельные изменения строк в странице, поскольку изменения не будут видны благодаря правилам видимости механизма MVCC.
Страница может быть закреплена несколькими процессами, поэтому в качестве признака закрепления используется именно счетчик. Когда страница не закреплена ни одним процессом, значение pin count = 0.
Помимо этого, при размещении страницы в буфере увеличивается на единицу счетчик ее использования usage count.
Указатель на свободный буфер смещается на следующий буфер по списку.
В хеш-таблице создается ссылка на только что занятый буфер. В качестве ключа хеширования используется идентификатор страницы.
Поиск страницы в кеше
При поиске страницы процесс сначала обращается к хеш-таблице.
Для этого он вычисляет номер буфера с использованием хеш-функции, на вход которой передает идентификатор страницы.
Если полученный номер буфера имеется в хеш-таблице, то процесс сверяет идентификатор необходимой страницы с идентификатором страницы, размещенной в буфере.
Такая проверка необходима, поскольку, как известно, в хеш-функциях могут быть коллизии — разным идентификаторам страниц может соответствовать одно и то же хеш-значение, то есть номер буфера.
Для разрешения коллизий используется механизм связанных цепочек номеров буферов, страницам которых соответствует одно и то же хеш-значение.
В результате при поиске буфера с использованием хеш-таблицы может потребоваться проверка нескольких буферов.
Если буфер, содержащий страницу, был найден, то он закрепляется (к pin count прибавляется единица) на время работы со страницей и увеличивается счетчик использования (к usage count прибавляется единица).
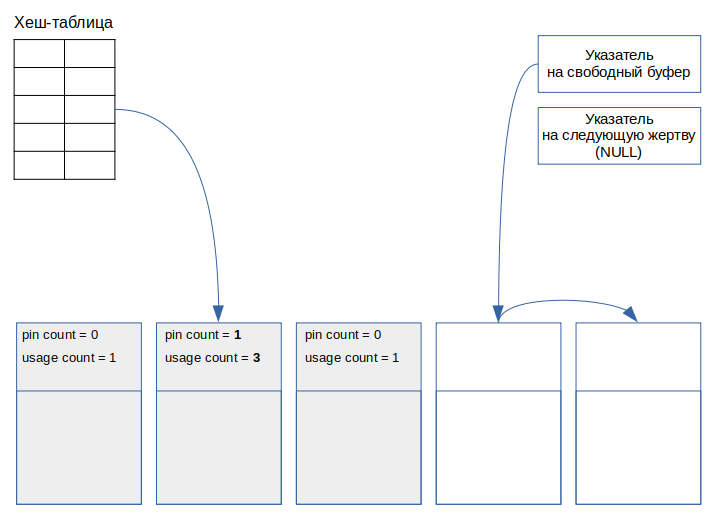
При этом значение usage count не может превышать 5. Причины этого будут объяснены ниже.
В случае, если в хеш-таблице не нашлось соответствующего буфера, страница считывается из файла и помещается в один из свободных буферов, ссылка на который хранится в указателе на свободный буфер.
Если при этом свободных буферов в кеше не осталось, то выполняется процедура вытеснения одной из редко используемых страниц в кеше.
Вытеснение страницы из буфера
Для вытеснения используется указатель на следующую жертву.
Указатель содержит ссылку на буфер, начиная с которого алгоритм вытеснения перебирает буферы по кругу, уменьшая на единицу значение usage count.
Как только он находит незакрепленный буфер со значением usage count, равным нулю, страница из найденного буфера вытесняется и на ее место помещается новая считанная из файла страница.
Как и положено в таких случаях, на время работы со страницей процесс закрепляет буфер.
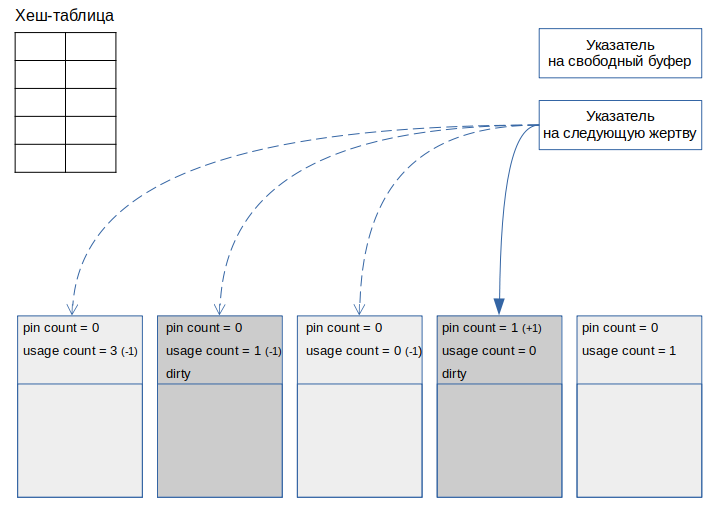
Если вытесняемая страница оказалась «грязной», то есть отличающейся от соответствующей страницы в файле, то она должны быть записана в файл.
Такая ситуация нежелательна, поскольку может значительно снижать скорость выполнения запросов.
Предотвращение случаев вытеснения «грязных» страниц обеспечивают процессы checkpointer и background writer, речь о которых пойдет в лекции «Запись грязных страниц».
Рассмотренный алгоритм носит название clock sweep, поскольку по аналогии с часовой стрелкой перемещается по кругу буферов в кеше в поисках жертвы для вытеснения.
Высокие значения usage count при таком алгоритме позволяют странице задержаться в буфере и не быть вытесненной в случае активного ее использования.
При этом пока алгоритм совершает проход по кругу, у буферов с небольшими значениями usage count есть время, чтобы их нарастить.
Однако если все буферы имеют ненулевое значение usage count и страницы в буфере активно используются, то алгоритму может потребоваться совершить более одного прохода в поисках жертвы на вытеснение.
Для недопущения большого количества проходов алгоритмом clock sweep значение usage count ограничено 5.
Необходимо отметить, что освобождение буферов в кеше происходит только в следующих случаях:
- при удалении отношения командой
DROP - при опустошении таблицы командой
TRUNCATE - при усечении последних пустых страниц в файле в ходе очистки
После освобождения буферы добавляются в список свободных буферов и используются для размещения новых страниц.
Буферное кольцо
Как теперь известно, алгоритм вытеснения работает так, чтобы активно используемые страницы не вытеснялись и оставались в кеше буферов.
Но, к сожалению, данный алгоритм бессилен в случае выполнения массового чтения или записи табличных страниц.
Однократный запрос, возвращающий большой объем данных, сопоставимый с размером кеша буферов, может вытеснить большую часть горячих страниц.
Для решения данной проблемы в кеше буферов выделяются небольшие наборы буферов, называемые буферными кольцами.
При массовом чтении или записи в таком случае используется не весь кеш, а выделенное для этого буферное кольцо.
Внутри буферного кольца также работает алгоритм вытеснения.
При этом страницы внутри буферного кольца могут использоваться и другими процессами, не выполняющими операции массового чтения или записи.
Если страница в буферном кольце становится «грязной» или счетчик использования буфера становится больше 1, то такой буфер исключается из буферного кольца и становится частью общего кеша буферов.
Для различных операций массового чтения или записи применяются различные стратегии использования буферного кольца, рассматриваемые ниже.
Массовое чтение через последовательное сканирование
При последовательном сканировании большой таблицы, размер которой превышает четверть размера кеша буферов, используется буферное кольцо, состоящее из 32 буферов.
Загрязненные буферы, например в результате выполнения команды UPDATE или обновления информационных битов в заголовке версий строк, не вытесняются в файлы данных, а перемещаются в общий кеш, и их вытеснение происходит по общим правилам.
На их место из общего кеша подключаются другие буферы.
Такая стратегия предполагает, что данные преимущественно читаются, а не изменяются.
Буферное кольцо при последовательном сканировании может использоваться совместно разными обслуживающими процессами.
При этом процесс, занявшийся сканированием таблицы, которая уже сканируется через буферное кольцо другим процессом, присоединяется к чтению посредством того же кольца.
Когда сканирование таблицы первым процессом завершено, присоединившийся процесс дочитывает часть таблицы, на которую он «опоздал».
Массовая запись
Для операций массовой записи, выполняемых такими командами, как COPY, CREATE TABLE AS SELECT, CREATE MATERIALIZED VIEW, выделяется буферное кольцо размером 2048 буферов, но не больше восьмой части всего кеша буферов.
Для таких операций нет смысла перемещать «грязные» буферы в общий кеш, поэтому они сразу вытесняются в файлы данных.
Очистка
При выполнении очистки или анализа полным сканированием таблиц без учета карты видимости также используется буферное кольцо, размер которого в этом случае определяется параметром vacuum_buffer_usage_limit (по умолчанию 32 страницы).
Также размер буферного кольца может быть задан параметром BUFFER_USAGE_LIMIT в командах VACUUM и ANALYZE.
«Грязные» буферы в данной стратегии сразу вытесняются в файлы данных.
Проблемы массовых операций
При выполнении массовых изменений командами UPDATE или DELETE может быть использовано буферное кольцо в соответствии со стратегией массового чтения.
В этом случае все массово измененные буферы будут открепляться от буферного кольца и попадать в общий кеш буферов, что сводит на нет преимущества использования буферного кольца.
Таким образом, стоит избегать операций массового изменения данных, а выполнять их небольшими порциями.
Также важной проблемой является то, что при индексном доступе никогда не используется буферное кольцо.
Предполагается, что метод индексного доступа выбирается планировщиком при высокой селективности запрашиваемых данных. Ожидается, что объем данных, полученных в результате индексного доступа, не является большим и проблем, связанных с вытеснением горячих страниц из кеша буферов, не будет.
Однако планировщик может ошибаться с оценкой селективности выборки и вместо последовательного сканирования выбирать метод индексного доступа. В результате этого горячие страницы из кеша могут вытесняться.
Решение данной проблемы требует регулярного выполнения анализа (автоанализа) с целью обеспечения актуальности статистики для планировщика.
Настройка кеша буферов
Размер кеша буферов определяется конфигурационным параметром shared_buffers.
Изменение его значения требует перезапуска экземпляра.
Значение по умолчанию параметра shared_buffers очень мало и составляет 128 MB.
При определении необходимого размера кеша буферов следует учитывать следующие аспекты.
Набор горячих данных, активно используемых при выполнении запросов, как правило, ограничен и является относительно небольшим.
Размер кеша буферов в идеале должен обеспечивать размещение всего объема горячих данных, а также иметь некоторый запас для одноразовых нечасто используемых данных. В противном случае активно используемые страницы будут часто вытесняться и тут же возвращаться в кеш, увеличивая количество операций ввода/вывода.
С другой стороны, использование чрезмерно большого размера кеша буферов является не только расточительством в отношении расходования оперативной памяти, но и приводит к избыточным накладным расходам по обслуживанию самого кеша буферов.
Мониторинг активности использования буферов может выполняться с использованием расширения pg_buffercache, с помощью которого в том числе можно построить распределение активности использования буферов на основе значения параметра usage count.
Помимо этого, системные представления pg_stat_io позволяют посмотреть общую статистику обращений к кешу буферов и файлам данных для различных отношений.
Также стоит помнить, что в Pangolin взаимодействие с энергонезависимой памятью осуществляется посредством кеша операционной системы.
Отсутствие необходимой страницы данных в кеше буферов не означает, что ее обязательно придется считать с энергонезависимой памяти. Она может оказаться в кеше операционной системы.
При начальной настройке часто рекомендуется установить значение параметра shared_buffers в 1/4 от объема имеющейся оперативной памяти. Но надо понимать, что после накопления достаточной статистики по имеющейся нагрузке это значение должно быть пересмотрено.
Итоги
- Работа со страницами данных происходит посредством кеша буферов
- Часто используемые страницы должны надолго задерживаться в кеше буферов
- Для операций массового чтения и записи используется буферное кольцо
- Размер кеша буферов должен быть таким, чтобы не происходило вытеснений активно используемых страниц
Самопроверка
Вопрос 1
В каких случаях происходит освобождение буферов в кеше буферов?
Вопрос 2
Какие условия необходимы для того, чтобы алгоритм вытеснения, перейдя на очередной буфер, вытеснил страницу из него?
Вопрос 3
Какое значение счетчика usage count является максимальным?
Вопрос 4
Таблица имеет размер 512 MB. Значение shared_buffers = 1024 MB.
Буферное кольцо какого размера будет задействовано при последовательном сканировании этой таблицы?