Физическое хранение данных
Все данные в базе данных хранятся в таблицах, которые в системе представлены набором файлов. Эти файлы делятся на основные и вторичные. В основных файлах лежат данные, а вторичные нужны для некоторых процессов СУБД.
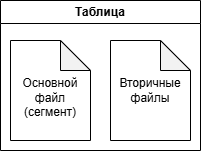
Рассмотрим структуру таблицы подробнее.
Сегменты
Таблица представляет собой набор файлов, и при ее создании чаще всего появляется только один основной, исключения — нежурналируемые таблицы (слой инициализации), таблицы с большими типами данных (TOAST сегмент) и таблицы с индексами (сегмент индекса). Файлы, содержащие в себе данные, принято называть сегментами. Их имя складывается из числового идентификатора (файлового узла) таблицы и порядкового номера сегмента.
Что такое файловый узел?
Файловый узел — числовой идентификатор, который напрямую используется в качестве имени файла данных в файловой системе сервера. В большинстве случаев при создании отношения файловый узел совпадает с oid этого объекта. Но при выполнении некоторых процессов PostgreSQL пересоздает файлы, что приводит к обновлению файлового узла. В то время как oid не меняется на протяжении всей жизни объекта.
В качестве примера создадим таблицу test.
postgres@sch_db=# CREATE TABLE test ();
CREATE TABLE
Обратимся к каталогу pg_class, в котором хранится метаинформация о таблицах. Для вывода информации по таблице test в удобном виде укажем значение поля relname и метакоманду \gx.
postgres@sch_db=# SELECT * FROM pg_class WHERE relname = 'test' \gx
-[ RECORD 1 ]-------+------
oid                 | 24891
relname             | test
relnamespace        | 2200
reltype             | 24893
reloftype           | 0
relowner            | 10
relam               | 2
relfilenode         | 24891
reltablespace       | 0
relpages            | 0
reltuples           | -1
relallvisible       | 0
reltoastrelid       | 0
relhasindex         | f
relisshared         | f
relpersistence      | p
relkind             | r
relnatts            | 0
relchecks           | 0
relhasrules         | f
relhastriggers      | f
relhassubclass      | f
relrowsecurity      | f
relforcerowsecurity | f
relispopulated      | t
relreplident        | d
relispartition      | f
relrewrite          | 0
relfrozenxid        | 1188
relminmxid          | 1
relacl              |
reloptions          |
relpartbound        |
Рассмотрим некоторые поля:
oid—oidтаблицы, задается при создании таблицы (обычно равенrelfilenode) и не меняется на протяжении ее жизни;relname— название таблицы;relfilenode—oidфайлового узла, числовой идентификатор группы файлов, относящийся к таблице, может меняться.
Чтобы увидеть смену oid файлового узла, выполним полную очистку таблицы, в процессе которой файлы таблицы test будут удалены и воссозданы вновь.
postgres@sch_db=# VACUUM FULL test;
VACUUM
Посмотрим на обновленную метаинформацию.
postgres@sch_db=# SELECT * FROM pg_class WHERE relname = 'test' \gx
-[ RECORD 1 ]-------+------
oid                 | 24891
relname             | test
relnamespace        | 2200
reltype             | 24893
reloftype           | 0
relowner            | 10
relam               | 2
relfilenode         | 24894
reltablespace       | 0
relpages            | 0
reltuples           | 0
relallvisible       | 0
reltoastrelid       | 0
relhasindex         | f
relisshared         | f
relpersistence      | p
relkind             | r
relnatts            | 0
relchecks           | 0
relhasrules         | f
relhastriggers      | f
relhassubclass      | f
relrowsecurity      | f
relforcerowsecurity | f
relispopulated      | t
relreplident        | d
relispartition      | f
relrewrite          | 0
relfrozenxid        | 1189
relminmxid          | 1
relacl              |
reloptions          |
relpartbound        |
Обратите внимание, что oid таблицы остался неизменным, в то время как relfilenode изменился с 24891 на 24894.
Чтобы посмотреть на сегмент, создадим новую таблицу.
postgres@sch_db=# CREATE TABLE tab_data (id integer, msg text);
CREATE TABLE
Теперь узнаем путь к таблице. Это можно сделать с помощью функции pg_relation_filepath().
postgres@sch_db=# SELECT pg_relation_filepath('tab_data');
pg_relation_filepath
----------------------
base/16389/16443
(1 row)
В качестве аргумента функция pg_relation_filepath() принимает имя объекта, а возвращает путь к его первому сегменту. Разберем путь на нашем примере:
base— каталог табличного пространства по умолчаниюpg_default;16389— файловый узел базы данныхsch_db;16443— файловый узел первого сегмента таблицыtab_data.
В разделе о табличных пространствах будет рассмотрена вариация пути с использованием пользовательского табличного пространства.
Зная путь к первому сегменту, можно вывести более подробную информацию о файле.
postgres@sch_db=#\! ls -l $PGDATA/base/16389/16443*
-rw------- 1 postgres postgres 0 Oct 14 10:16 /pgdata/06/data/base/16389/16443
В конце пути используется *, но выводится лишь один файл — первый сегмент таблицы tab_data. Вторичные файлы будут созданы автоматически при необходимости.
В информации о файле можем видеть:
-rw------- 1— тип файла, права доступа и количество ссылок;postgres postgres— владельца файла и группу, которой файл принадлежит;0— размер файла;Oct 14 10:16— дата и время создания файла;/pgdata/06/data/base/16389/16443— абсолютный путь к файлу.
Вставим одну строчку в таблицу и посмотрим на изменения.
postgres@sch_db=# INSERT INTO tab_data(id) VALUES (1, );
INSERT 0 1
postgres@sch_db=# \! ls -l $PGDATA/base/16389/16443*
-rw------- 1 postgres postgres 8192 Oct 14 20:20 /pgdata/06/data/base/16389/16443
Как видно, изменился только размер сегмента — теперь он 8 КБ. Такое большое изменение размера по сравнению со вставленной строчкой данных обусловлено организацией хранения данных внутри большинства файлов. А именно — использованием страниц.
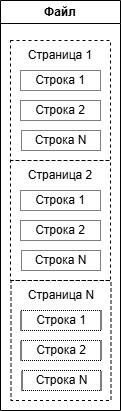
Страницы в файлах схожи своим назначением со страницами в обычных книгах. Они разбивают весь объем данных в файле на блоки по 8 КБ. Данный размер стоит по умолчанию, однако его можно изменить при сборке экземпляра. Даже если файл содержит одну строчку данных, под нее будет выделена целая страница, как в нашем примере.
Когда размер сегмента, то есть содержимого всех страниц файла, достигнет 1 ГБ, будет выделен новый сегмент, имя которого также формируется из файлового узла таблицы, но с добавлением порядкового номера, начиная с единицы через точку.
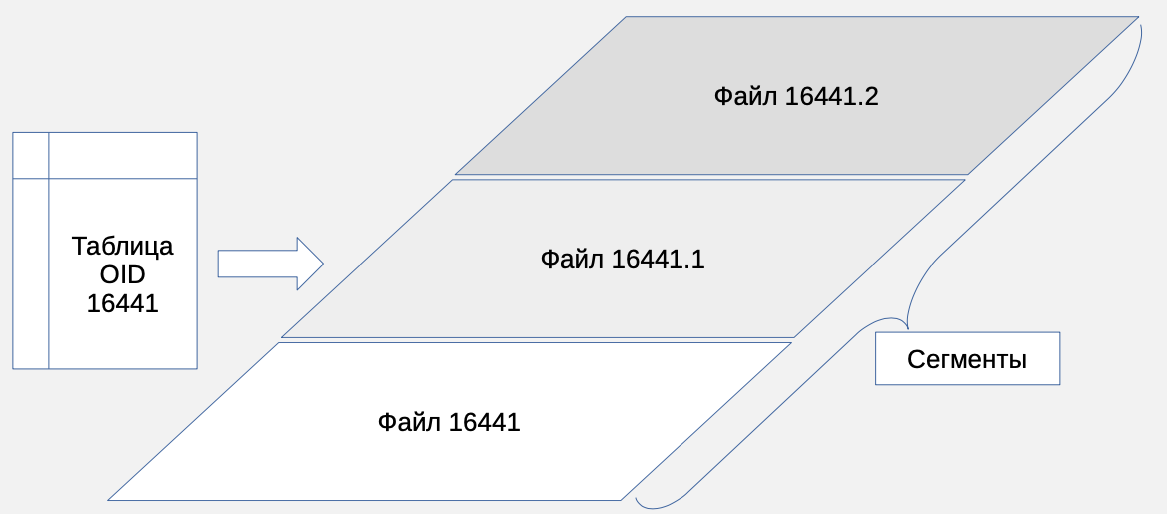
В схеме выше файловый узел таблицы 16441 — его наследуют все файлы данной таблицы. Имя первого сегмента совпадает с файловым узлом таблицы — 16441. Второй сегмент уже имеет порядковый номер 1 — 16441.1, название третьего — 16441.2, и так далее.
Слои
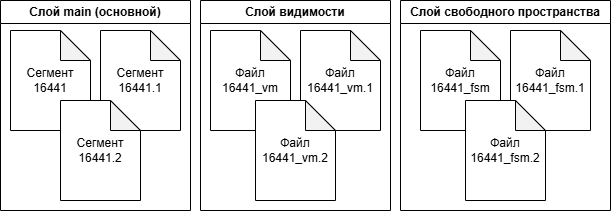
Все файлы таблицы делятся на 3 вида: основные, карты видимости и карты свободного пространства. Карты относятся к вторичным файлам, которые создаются системой при необходимости. Объединение файлов одного вида называется слоем. Посмотрим на слои подробнее.
- Основной слой (main fork) включает в себя данные — табличные и индексные строки. Основной слой существует для любых отношений (кроме представлений, которые не содержат данных).
- Слой свободного пространства (free space map — fsm) объединяет fsm-файлы, необходимые для ускорения поиска свободного места на страницах данных при операциях вставки и обновления. Сама карта организована в виде дерева и занимает от трех страниц. Файлы слоя свободного пространства имеют суффикс
_fsmи растут, как и сегменты: при достижении 1 ГБ создается новый файл, к имени которого добавляется порядковый номер, начиная с единицы. Этот слой существует у таблиц и индексов. - Слой видимости (visibility map — vm) существует только для таблиц, и в его vm-файлах отмечаются те страницы, на которых все версии строк актуальны. Реализовано это с помощью двух битов, которые выделяются на каждую страницу основного файла — сегмента. Страницы с актуальными версиями строк команда
VACUUMпри следующем запуске пропускает, так как на них нет «мертвых» (dead) версий, подлежащих чистке.
Как формируется карта свободного пространства?
При активной работе с таблицей на страницах сегментов образуются «дыры» — пустое место без данных. Такое бывает после удаления части данных или их изменении. PostgreSQL старается экономить место на диске, поэтому, например, когда в таблицу добавляется новая строка, он ищет одну из таких дыр, куда поместились бы новые данные. Если таблица достаточно большая, поиск свободного места для строки данных может затянуться. Для решения этой проблемы и нужна карта свободного пространства. Она составляется в процессе очистки таблицы, и в нее записываются все «дыры» сегмента. Таким образом при следующей вставке данных PostgreSQL не придется искать свободное место, он сразу обратится к карте и найдет нужное место.
Такой же процесс происходит при изменении данных. Строка с измененными данными считается новой, и PostgreSQL начинает процесс вставки данных в таблицу. Строка со старыми данными помечается как мертвая и подлежит удалению. Подробнее об этом процессе будет рассказано в курсе DBA2.
Как уже говорилось ранее, карты видимости и свободного пространства появляются не сразу, а по необходимости. Но при выполнении очистки таблицы вручную, они создаются принудительно. Посмотрим на этот процесс на следующем примере.
postgres@sch_db=# VACUUM tab_data;
VACUUM
postgres@sch_db=# \! ls -l $PGDATA/base/16389/16443*
-rw------- 1 postgres postgres  8192 Oct 17 14:17 /pgdata/06/data/base/16389/16443
-rw------- 1 postgres postgres 24576 Oct 17 14:17 /pgdata/06/data/base/16389/16443_fsm
-rw------- 1 postgres postgres  8192 Oct 17 14:17 /pgdata/06/data/base/16389/16443_vm
После ручного запуска процесса очистки были созданы вторичные файлы: карта свободного пространства 16443_fsm и карта видимости 16443_vm. Карта свободного пространства имеет размер 24576 КБ, что соответствует трем страницам по 8 КБ. Карта видимости совпадает по размеру с сегментом, поскольку в vm-файле создается столько страниц, сколько находится в сегменте.
Кроме описанных выше видов слоев есть и более специфичные: слой инициализации и слои временных таблиц.
Слои нежурналируемых таблиц
Слой инициализации (init fork) создается только у нежурналируемых таблиц в дополнение к основному и вторичным. Такие таблицы не пишут транзакции в журнал WAL, за счет чего изменения в них производятся быстрее, но в случае сбоя все данные будут потеряны. При восстановлении нежурналируемой таблицы слой инициализации будет записан поверх сегмента, а все другие слои будут удалены.
Воспроизведем ситуацию, когда после работы с нежурналируемой таблицей произошел сбой, и посмотрим на изменения в слоях таблицы. Сначала нужно создать нежурналируемую таблицу. Для этого укажем тип таблицы с помощью ключевого слова UNLOGGED.
postgres@sch_db=# CREATE UNLOGGED TABLE unl_tab (id integer, datum timestamp DEFAULT now());
Чем является второй столбец?
Второй столбец с названием datum имеет тип timestamp, который предназначен для хранения даты и времени. Ключевое слово DEFAULT задает в качестве значения по умолчанию функцию now(), возвращающую текущие время на экземпляре.
Дальше в примере будет вставка строки данных со значением только первого столбца именно потому, что значение второго система рассчитает автоматически на основе функции по умолчанию.
CREATE TABLE
postgres@sch_db=# INSERT INTO unl_tab VALUES (1);
INSERT 0 1
postgres@sch_db=# SELECT pg_relation_filepath('unl_tab');
pg_relation_filepath
---------------------
base/16389/16448
(1 row)
postgres@sch_db=# \! ls -l $PGDATA/base/16389/16448*
-rw------- 1 postgres postgres 8192 Oct 16 21:11 /pgdata/06/data/base/16389/16448
-rw------- 1 postgres postgres    0 Oct 16 21:11 /pgdata/06/data/base/16389/16448_init
Как видно, вместе с сегментом основной таблицы был создан init-файл. Он представляет собой пустую версию сегмента.
Теперь произведем очистку таблицы.
postgres@sch_db=# VACUUM unl_tab;
VACUUM
postgres@sch_db=# \! ls -l $PGDATA/base/16389/16448*
-rw------- 1 postgres postgres  8192 Oct 16 21:11 /pgdata/06/data/base/16389/16448
-rw------- 1 postgres postgres 24576 Oct 16 21:11 /pgdata/06/data/base/16389/16448_fsm
-rw------- 1 postgres postgres     0 Oct 16 21:11 /pgdata/06/data/base/16389/16448_init
-rw------- 1 postgres postgres  8192 Oct 16 21:11 /pgdata/06/data/base/16389/16448_vm
После очистки появились слои видимости и свободного пространства, как у обычных таблиц.
Для имитации сбоя отправим процессам postgres сигнал SIGQUIT, а затем снова запустим сервер и проверим слои.
[student@ServerName ~]$ sudo killall -QUIT postgres
[student@ServerName ~]$ sudo systemctl start postgresql
postgres@sch_db=# \! ls -l $PGDATA/base/16389/16448*
-rw------- 1 postgres postgres  0 Oct 16 21:11 /pgdata/06/data/base/16389/16448
-rw------- 1 postgres postgres  0 Oct 16 21:11 /pgdata/06/data/base/16389/16448_init
Из-за сбоя система переписала сегмент с помощью слоя инициализации, из-за чего данные в нем были потеряны и размер стал равен 0 КБ. Остальные слои были удалены.
Слои временных таблиц
Еще один специфичный вид слоев — слои временных таблиц. Несмотря на ограниченный срок жизни рамками сессии или транзакции, временные таблицы имеют все те же слои, что и обычные таблицы. Однако в названии присутствует префикс tN_, где N — номер временной схемы, которой принадлежит таблица.
Создадим временную таблицу, вставим в нее строку данных и проверим слои.
postgres@sch_db=# CREATE TEMP TABLE tmp_tab (id text, dt timestamp DEFAULT now());
CREATE TABLE
postgres@sch_db=# INSERT INTO tmp_tab (id) VALUES ('Запись');
INSERT 0 1
postgres@sch_db=# SELECT pg_relation_filepath('tmp_tab');
 pg_relation_filepath
----------------------
 base/16389/t7_16460
(1 row)
postgres@sch_db=# \! ls -l $PGDATA/base/16389/t7_16460*
-rw------- 1 postgres postgres 8192 Oct 25 14:17 /pgdata/06/data/base/16389/t7_16460
В названии сегмента виден префикс и номер временной схемы, в нашем случае — 7.
Теперь очистим таблицу и посмотрим на изменения в слоях.
postgres@sch_db=# VACUUM tmp_tab;
VACUUM
postgres@sch_db=# \! ls -l $PGDATA/base/16389/t7_16460*
-rw------- 1 postgres postgres  8192 Oct 17 14:17 /pgdata/06/data/base/16389/t7_16460
-rw------- 1 postgres postgres 24576 Oct 17 14:17 /pgdata/06/data/base/16389/t7_16460_fsm
-rw------- 1 postgres postgres  8192 Oct 17 14:17 /pgdata/06/data/base/16389/t7_16460_vm
Появились карты видимости и свободного пространства. В их названии также есть префикс tN_.
Хранение больших атрибутов
В приведенных выше примерах в таблицы добавляли строки с малым количеством данных. Однако в жизни данные могут быть достаточно больших размеров. Например, тип данных VARCHAR позволяет хранить строки длиной 10485760 символов, а максимальный размер строки типа TEXT почти 1 ГБ. Но здесь всплывает два ограничения:
- строка может находиться только внутри одной страницы;
- размер страницы 8 КБ.
То есть может возникнуть ситуация, когда в таблице уже есть данные, и добавляемая строка хоть и небольшая, но целиком уже не помещается. Либо размер добавляемых данных настолько велик, что даже пустой страницы не хватает на целостное размещение новой строки. Для выхода из таких ситуаций существует технология TOAST (The Oversized Attributes Storage Technique). Она реализует 4 стратегии работы с данными:
plain— данная стратегия применяется для заведомо «коротких» типов данных (например,integer), когда необходимости в использовании TOAST нет;extended— данные сначала сжимают, а затем переносят в отдельную TOAST таблицу;external— длинные значения хранятся в TOAST таблице несжатыми;main— длинные значения в первую очередь сжимаются, а в TOAST таблицу попадают, только если сжатие не помогло.
На выбор стратегии влияет тип столбца с данными. Но алгоритмы PostgreSQL стараются вписать на страницу хотя бы 4 строки. Поэтому если размер строки превышает четвертую часть страницы (без учета заголовка), к некоторым данным будет применена технология TOAST. Примерный алгоритм анализа строк:
- Выбираются данные из столбцов со стратегиями
externalиextended, двигаясь от самых длинных к более коротким. Данные со стратегиейextendedсначала сжимаются, и если они все еще превосходят четверть страницы, отправляются в TOAST таблицу. При стратегииexternalданные обрабатываются так же, но не сжимаются. - Если после первого прохода строка все еще не помещается, в TOAST таблицу по одному отправляются оставшиеся столбцы со стратегиями
externalиextended. - Если и это не помогло, идет попытка сжать данные из столбцов со стратегией
main, оставляя их на странице исходной таблицы. - Если строка все равно недостаточно коротка, в TOAST таблицу помещаются данные из столбцов со стратегией
main.
Упомянутая TOAST таблица предназначена для хранения всех длинных данных основной таблицы. Если в столбцах основной таблицы указаны потенциально большие типы данных, TOAST таблица будет создана автоматически, даже если фактическая длина строк позволяет им помещаться на страницу сегмента целиком.
В метаданных таблиц есть специальное поле (reltoastrelid в таблице pg_class), идентифицирующее TOAST таблицу, в которой будут храниться фрагменты «длинных» полей. Таблицы TOAST находятся в специальной схеме pg_toast.
Итоги
- Таблица — это набор файлов (сегментов), каждый из которых не превышает 1 ГБ; при достижении лимита создается новый сегмент с порядковым номером;
- Файловый узел (
relfilenode) — числовой идентификатор, используемый в качестве имени файла; может меняться (например, послеVACUUM FULL), в отличие от неизменяемогоoid; - Слой (fork)
main— основной, содержит данные; существует для любых отношений кроме представлений; - Слой
fsm(free space map) — карта свободного пространства, ускоряет поиск свободного места при вставке и обновлении; существует у таблиц и индексов; - Слой
vm(visibility map) — карта видимости, отмечает страницы с актуальными версиями строк; существует только у таблиц; - Слой
init(init fork) — слой инициализации, существует только у нежурналируемых (UNLOGGED) таблиц; при сбое переписывает сегмент, удаляя все данные; - Временные таблицы имеют префикс
tN_в именах сегментов, гдеN— номер временной схемы; - Технология TOAST хранит длинные значения, не помещающиеся на одну страницу (8 КБ): данные сжимаются и/или переносятся в отдельную TOAST таблицу;
- Стратегии TOAST:
plain(без TOAST),extended(сжатие + перенос),external(перенос без сжатия),main(сжатие на месте, перенос если не помогло).
Самопроверка
Вопрос 1
Какая функция показывает путь до файла таблицы, относительно PGDATA?
Вопрос 2
Для каких отношений создается слой init?
Вопрос 3
Какой максимальный размер одного сегмента таблицы?
Вопрос 4
Выполнена команда CREATE TABLE t1 (id integer);. Какие файлы (слои) появятся в файловой системе сразу после создания таблицы?
Вопрос 5
Какая стратегия TOAST сначала сжимает данные, а затем переносит в TOAST-таблицу?