Уровень 2.0
Предусловие: изучен модуль «Работа в среде psql» данного курса
В этой главе мы рассмотрим внутреннее устройство СУБД Pangolin – как организованы процессы, память, хранение данных и выполнение запросов.
Архитектура
Работа СУБД Pangolin основана на деятельности отдельных процессов postgres, работающих скоординированно. Первым запускается процесс postgres, называемый далее postmaster. Он порождает одноименные дочерние процессы (backend), обслуживающие клиентов и выполняющие служебные задачи. Процессы взаимодействуют и имеют доступ к общей памяти.
Команда initdb создает в каталоге данных PGDATA файлы и каталоги, необходимые для работы СУБД и хранения данных. СУБД обслуживает несколько баз данных — кластер баз данных. Процессы, файлы и структуры в памяти — экземпляр.
При запуске экземпляра головной процесс postmaster организует необходимые для межпроцессного взаимодействия IPC структуры, например, разделяемую память, и открывает средства сетевого взаимодействия. Далее с помощью системного вызова fork() запускаются копии этого процесса. Дочерние процессы выполняют работу асинхронно и независимо друг от друга, но под общим управлением postmaster.
Процессы экземпляра на равноправных условиях имеют доступ к разделяемым ресурсам кластера баз данных и структурам в файловой системе, созданным с помощью initdb.
Экземпляр PostgreSQL обслуживает сразу несколько баз данных, которые и образуют кластер баз данных.
Экземпляр
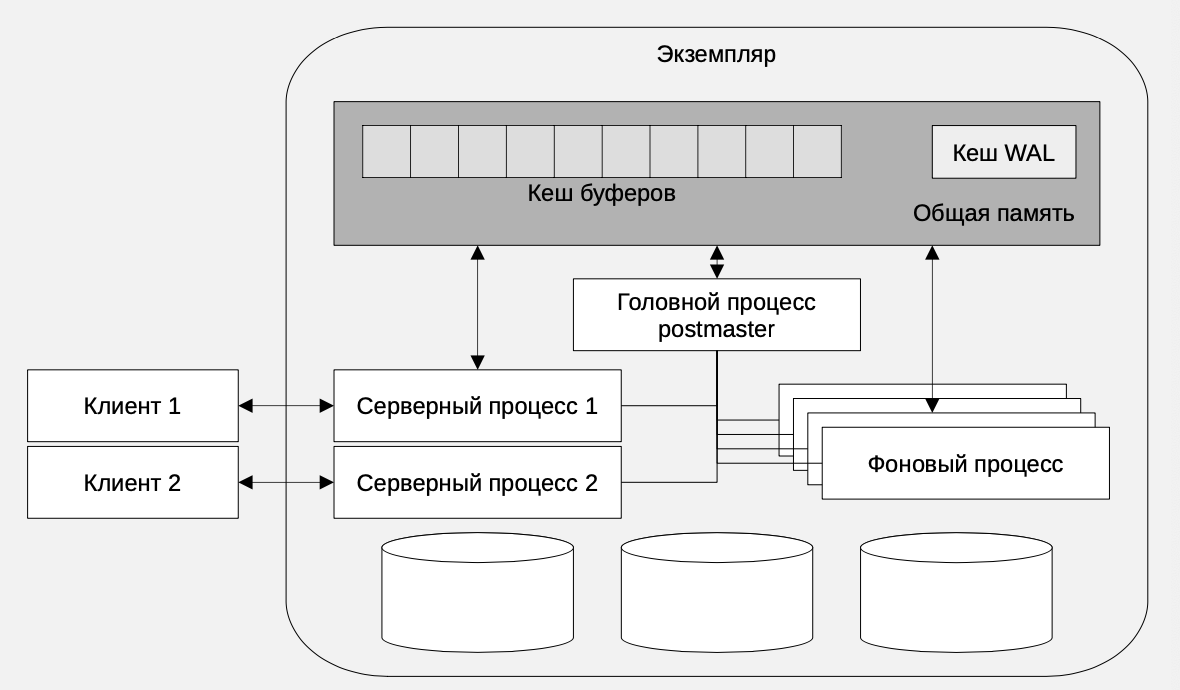 .
В разделяемой памяти экземпляра, доступной серверным процессам (backend), находится несколько структур данных, главная из которых — буферный кеш. Он предназначен для размещения страниц данных, считанных с диска из файлов данных и обрабатываемых процессами.
При подключении клиента после успешной аутентификации для него создается персональный серверный процесс (client backend). Когда клиент выполняет запрос SQL, происходит следующее:
- На этапе планирования запроса определяется, какие страницы данных требуются (например, при полном сканировании таблицы нужны все ее страницы).
- Проверяется, есть ли нужные страницы в буферном кеше. Если страниц в кеше нет, они считываются с диска из файлов данных. Для определения, какие файлы надо читать, используются метаданные (данные о данных) из системного каталога. Считанные страницы помещаются в буферный кеш.
- Вся дальнейшая работа с данными (чтение, изменение) происходит в буферном кеше.
- Измененные страницы («грязные») позже записываются обратно на диск.
- Для исключения одновременного изменения данных разными процессами, работающими асинхронно, существует система блокировок.
Активность процессов
Информацию о процессах экземпляра, порожденных головным процессом (postmaster) можно получить из представления pg_stat_activity:
postgres@postgres=# SELECT pid, backend_type FROM pg_stat_activity;
 pid | backend_type
-----+------------------------------
 921 | autovacuum launcher
 922 | autounite launcher
 924 | logical replication launcher
 923 | integrity check launcher
2485 | client backend
 907 | background writer
 906 | checkpointer
 919 | walwriter
(8 rows)
Где:
client backend— серверный процесс, обслуживающий клиента;checkpointer— процесс контрольной точки, необходим для периодической записи «грязных» страниц на накопители;background writer— записывает измененные страницы, которые могут быть вскоре вытеснены на диск обслуживающими процессами;walwriter— записывает содержимое кеша WAL в журнал предзаписи;autovacuum launcher— запускает рабочие процессы автоочистки;logical replication launcher— запускает рабочие процессы для логической репликации.
Специфичные для Pangolin процессы:
autounite launcher— для объединения индексов в партиционированных таблицах;integrity check launcher— для проверки целостности.
Подробнее о представлении pg_stat_activity будет рассказано в главе «Обслуживание СУБД».
Посмотрим на список процессов экземпляра средствами операционной системы:
postgres@postgres=# \! ps f -C postgres
PID TTY STAT TIME COMMAND
811 ?   Ss 0:00 /usr/pangolin-{pangolin-version}/bin/postgres -D /pgdata/06
906 ?   Ss 0:00 \_ postgres: checkpointer
907 ?   Ss 0:00 \_ postgres: background writer
909 ?   Ss 0:00 \_ postgres: idle sessions terminator
919 ?   Ss 0:00 \_ postgres: walwriter
920 ?   Ss 0:00 \_ postgres: license checker
921 ?   Ss 0:00 \_ postgres: autovacuum launcher
922 ?   Ss 0:00 \_ postgres: autounite launcher
923 ?   Ss 0:00 \_ postgres: integrity check launcher
924 ?   Ss 0:00 \_ postgres: logical replication launcher
2485 ?   Ss 0:00 \_ postgres: postgres postgres [local] idle
Локальная память процессов
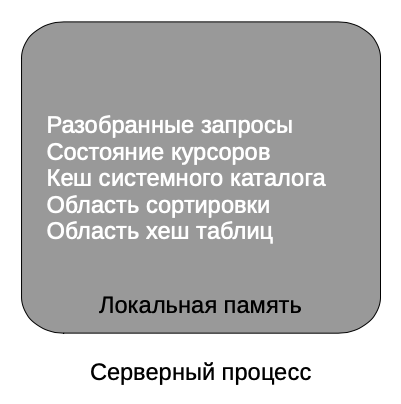
Каждый обслуживающий процесс имеет собственное адресное пространство памяти. В локальной памяти процессов размещаются:
Хранение данных
Данные должны храниться на надежных энергонезависимых носителях. В PostgreSQL хранение данных основано на использовании файловых систем. Объекты, содержащие данные, например таблицы, представлены наборами файлов. Эти файлы физически хранятся в табличных пространствах, организованных с помощью специальных каталогов.
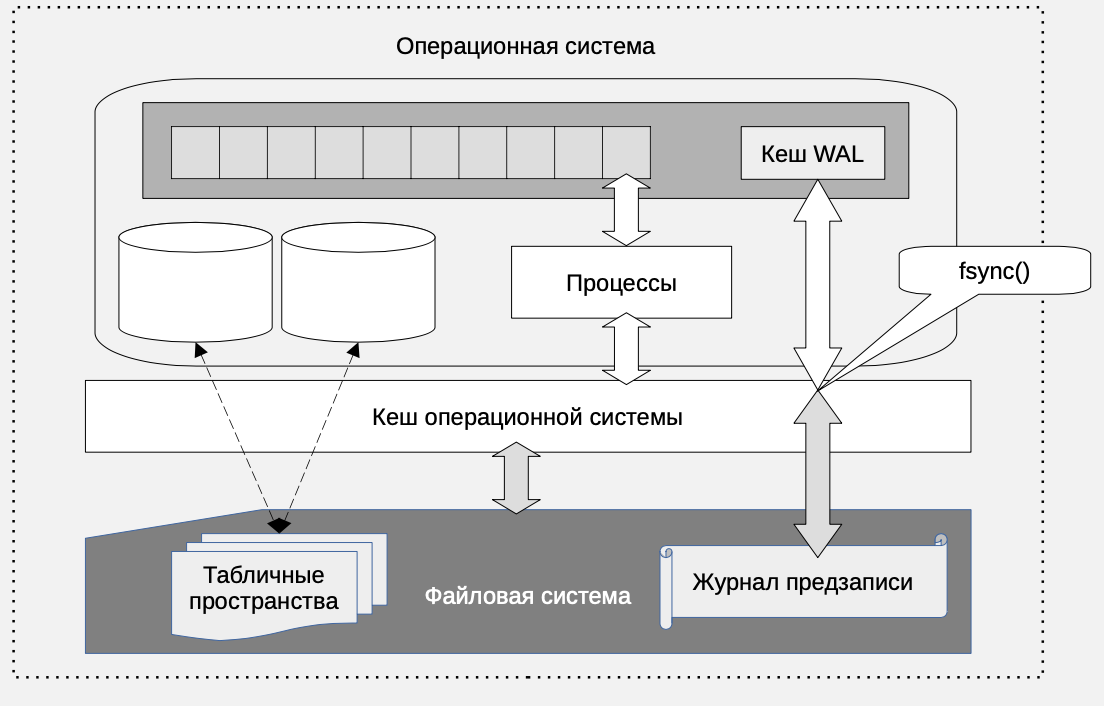
Каждая база данных в PostgreSQL имеет табличное пространство по умолчанию, но объекты, принадлежащие этой базе данных, могут размещаться в разных табличных пространствах. И наоборот, в одном табличном пространстве могут находиться объекты, принадлежащие разным базам данных.
Подробнее об этом рассказано в главе «Физическое хранение данных». В файловой системе PostgreSQL хранит не только файлы данных, там находятся файлы, сохраняющие состояние транзакций, журнал транзакций WAL и многое другое.
Все структуры данных за исключением физических мест размещения табличных пространств находятся в каталоге данных, определенном с помощью опции -D команды initdb или переменной окружения PGDATA.
Каталог данных кластера БД
При инициализации кластера БД командой initdb в каталоге данных PGDATA создается набор файлов и каталогов для работы СУБД. Рассмотрим содержимое каталога данных (в нашем случае PGDATA = /pgdata/06/data):
[postgres@ServerName ~] ls -F /pgdata/06/data
base/           pg_multixact/       pg_snapshots/              pg_xact/
global/         pg_notify/          pg_stat/                   postgresql.auto.conf
pg_commit_ts/   pg_perf_insights/   pg_stat_tmp/               postgresql.conf
pg_dynshmem/    pg_commit_ts/       pg_subtrans/               postmaster.opts
pg_hba.conf     pg_prep_stats/      pg_subtrans/               postmaster.opts
pg_ident.conf   pg_quota.conf       pg_twophase/               PRODUCT_VERSION
pg_integrity/   pg_replslot/        PG_VERSION                 tracing/
pg_logical/     pg_serial/          pg_wal/
По умолчанию команда initdb устанавливает на этот каталог права доступа 700 (drwx------), то есть полные права для владельца postgres. Однако при инициализации команде initdb можно добавить опцию -g, в результате чего права на каталог данных будут установлены 750 (drwxr-x---), с правами на чтение для членов группы postgres. Такие права могут потребоваться некоторым утилитам резервного копирования.
В каталоге base размещается табличное пространство по умолчанию (оно называется pg_default). Это табличное пространство будет использоваться для размещения данных отношений (таблиц, индексов и так далее), если для них или для всей их базы данных не указано иное табличное пространство.
Этапы выполнения запроса
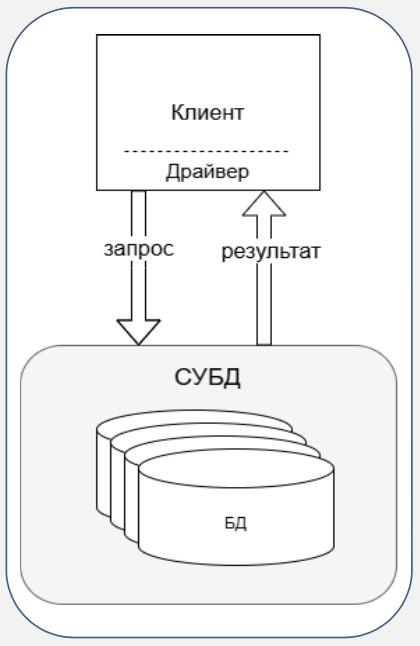
Когда в клиентском приложении вводится SQL-запрос, он поступает на сервер и далее выполняется сервером. Получив запрос от клиента, сервер для обычных случаев использует базовый протокол выполнения, состоящий из следующих стадий:
- Разбор (parse) — построение дерева запроса.
- Переписывание (rewriting) — преобразование запроса в соответствии с правилами. Это делается автоматически, но с помощью правил переписывания на этот процесс потенциально можно влиять (не рекомендуется).
- Планирование — планировщик выбирает минимально затратный способ выполнения запроса.
- Выполнение – исполнительный механизм выполняет запрос по выбранному плану.
Результаты выполнения или сообщения об ошибках отправляются клиенту.
Если используются подготовленные запросы или курсоры, то вместо базового протокола используется расширенный протокол.
Расширенный протокол
Для подготовленных запросов и курсоров используется расширенный протокол. Он отличается от базового протокола возможностью непосредственного управления этапами выполнения запроса.
При подготовке оператора (PREPARE) или создании курсора (DECLARE CURSOR) выполняются разбор и переписывание. Результаты кешируются в локальной памяти процесса вместо повторения этих фаз при каждом выполнении запроса.
Когда подготовленный запрос, уже прошедший ранее разбор и переписывание, подвергается выполнению посредством команды EXECUTE, тогда при необходимости выполняется привязка (bind) конкретных значений параметров запроса и его выполнение. То есть экономия заключается в том, что не надо каждый раз выполнять разбор и переписывание подготовленного запроса.
Для курсоров имеется дополнительная возможность по сравнению с подготовленными запросами, заключающаяся в пошаговом исполнении запроса.
Кеш буферов
Данные хранятся в виде страниц фиксированного размера (обычно 8 КБ), каждая из которых содержит версии строк таблицы. Файлы данных, хранящие строки таблиц и других отношений, состоят из страниц фиксированного размера, по умолчанию 8 Кб. Когда любому процессу экземпляра необходима информация (строка или строки) из какого-либо отношения, используются метаданные в системном каталоге, с помощью которых определяется, в каком файле находятся искомые страницы.
Работа с данными происходит в кеше буферов – области разделяемой памяти, куда из файлов данных считываются страницы с версиями строк при обращении. Когда процессу требуется строка, он выполняет поиск соответствующей страницы в буферном кеше. Если ее там нет, страница считывается с диска в буфер.
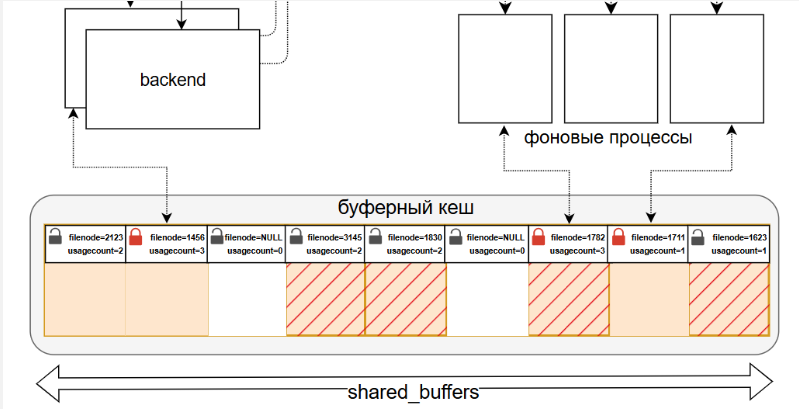
Измененные («грязные») страницы сохраняются на диске позже, например, при наступлении контрольной точки или при нехватке свободного пространства в кеше. Такая отложенная запись обеспечивается механизмом журнала предзаписи (WAL) для защиты данных от сбоев.
Заголовок буфера
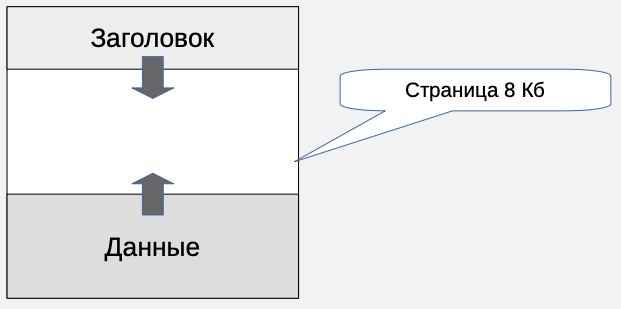
У каждого буфера в кеше имеется заголовок. В этом заголовке находятся сведения о состоянии страницы в этом буфере:
buffer_id— идентификатор буфера;buffer pin_lock— признак закрепление буфера за процессом (пока процесс работает со страницей, она не может быть вытеснена);usage count— счетчик количества обращений (используется для алгоритма вытеснений);filenode+blocknumber— название сегмента и номер страницы;isdirty— признак наличия изменений (буфер грязный).
Чтение в свободный буфер
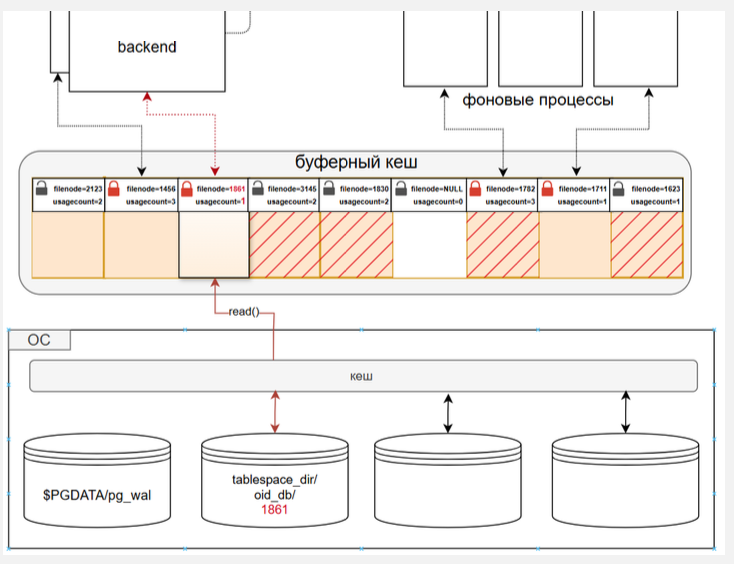
Если в кеше есть свободные буферы и какому-либо процессу понадобилась страница, то она просто считывается из соответствующего файла в свободный буфер. Но чаще всего буферы заняты и необходимо произвести вытеснение страницы, освободив таким образом буфер.
Вытеснение
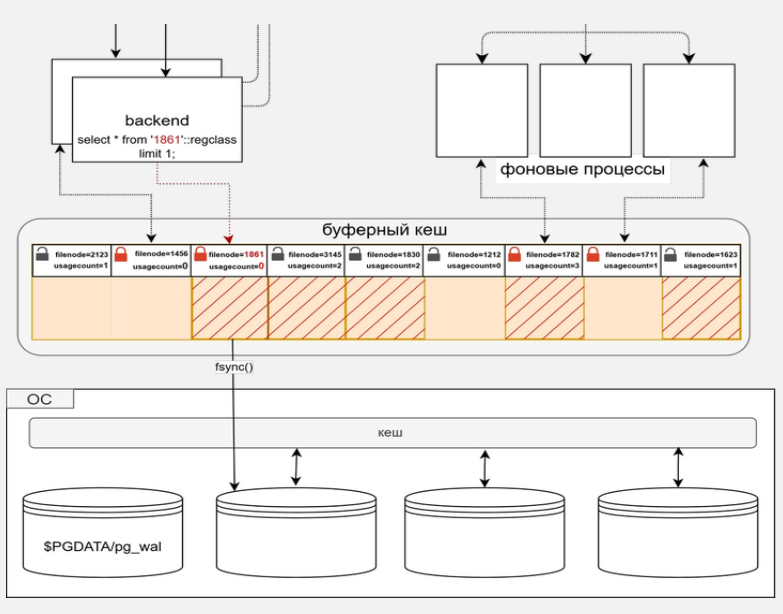
Для определения того, какую страницу из кеша буферов можно вытеснить, используются счетчик прикреплений Pin count и счетчик использований Usage count. Счетчик Usage count увеличивается при обращении любого процесса к этому буферу до значения 5. Но по алгоритму LRU регулярно происходит обход всех буферов в кеше, на каждом круге (clock sweep) которого происходит уменьшение счетчика Usage count на единицу.
Счетчик Pin count имеет ненулевое значение для тех буферов, которые требуются некоторым процессам в кеше буферов, то есть буфер прикреплен для выполнения некоторой операции.
Имеется специальный «указатель на следующую жертву» (next victim), который указывает на страницу, у которой Usage count = 0 и Pin count = 0. Это редко используемая страница, и ее можно вытеснить.
Записью «грязных» страниц могут заниматься различные процессы (checkpointer, backgroud writer, client backend). Стоит отметить, что если процессу client backend часто приходиться заниматься записью «грязных» страниц, то это свидетельствует о неправильной конфигурации экземпляра.
Итоги
- Экземпляр представлен скоординированно работающими процессами, общей памятью и каталогом данных.
- Кластер баз данных состоит из нескольких баз данных, обслуживаемых экземпляром.
- Процессы обслуживают клиентов и отвечают за выполнение служебных действий в СУБД.
- Каждый процесс обладает собственной локальной памятью.
- Клиентские запросы разбираются, переписываются, планируются и выполняются сервером СУБД.
- Данные в виде строк размещаются на страницах в файлах данных.
- Работа со страницами производится через кеш буферов.
- При отсутствии в кеше буферов места для размещения страницы происходит вытеснение давно неиспользуемой незакрепленной страницы.