Руководство по обеспечению надежности
Механизм для ограничения входящих запросов Rate Limiter
Для ограничения количества запросов в единицу времени GradeLy использует java-based и/или SRLS-based решение.
Java-based:
- фильтрация происходит на уровне сервлет-контейнера, изолируя основное приложение;
- количество проходящих Rate Limiter запросов в секунду отбрасываются в качестве метрики;
- конфигурация задается через ConfigMap в DropApp.
SRLS-based:
- фильтрация происходит на уровне отдельного сервиса SRLS, на моменте получения запроса граничным прокси (IGEG);
- не требует повторного развертывания приложения;
- конфигурация задается через ConfigMap в DropApp.
С помощью Rate Limiter можно точечно настроить:
- защиту конкретных эндпойнтов;
- максимальное число запросов в промежуток времени;
- ограничение трафика по CN отправителя;
- промежуток в единицах времени, для которого выполняется ограничение.
Механизм Rate Limiter одинаково подключается и эксплуатируется для Console (java-based и SRLS) и Worker(java-based).
Определение максимальной нагрузки
Для определения максимальной нагрузки, которую следует задать с помощью механизма Rate Limiter, проведите тест определения максимальной производительности.
Нагрузка должна быть ограничена с помощью механизма Rate Limiter на уровне, не превышающем показатели теста максимальной производительности.
Сценарий тестирования
При тестировании происходит пошаговое увеличение нагрузки с нуля до предельной (с шагом 20% от плановой). Пошаговое увеличение происходит до тех пор, пока не нарушится критерий успешности по количеству ошибок и/или времени отклика (что наступит раньше). Время работы теста на каждом шаге после стабилизации нагрузки составляет 10 минут.
Цель тестирования
По результатам тестирования устанавливается:
- уровень нагрузки L0 — последний шаг нагрузки, на котором не были нарушены критерии успешности;
- уровень нагрузки Llim — предельный уровень нагрузки, при котором не был нарушен критерий по количеству ошибок;
- уровень утилизации CPUlim — утилизация CPU на уровне нагрузки Llim.
Ожидаемый результат
-
Определен уровень максимальной производительности. L0 удовлетворяет одному из следующих уровней нагрузки (при использовании ресурсов всеми подами не больше, чем на OSE):
- Lmax для предыдущего релиза;
- Запросите аналитическую оценку команды по плановой нагрузке на сервис на год вперед, если не достигнут Lmax (при суммарных ресурсах как на OSE);
- Используйте критерий 10х от промышленной нагрузки на сервис, если не достигнута плановая нагрузка на год вперед.
-
Определен уровень нагрузки Llim.
-
Определен уровень утилизации CPUlim.
Профиль нагрузки
Моделирование нагрузки производится с использованием средств нагрузочного тестирования путем эмуляции действий определенного количества пользователей. Каждый виртуальный пользователь (программный процесс, эмулирующий действия физического пользователя АС) циклически выполняет пользовательский сценарий.
Подача нагрузки
- JMeter подает нагрузку на БД Source Pangolin, выполняя PL/pgSQL-функцию
NewOrder, которая включает в себя три операцииINSERTи одну операциюUPDATE; - Первый модуль захвата и изменений GraDeLy вычитывает сгенерированные данные из БД Source Pangolin и записывает их в Kafka;
- Модуль применения изменений вычитывает данные из Kafka и применяет их на БД Replica Pangolin.
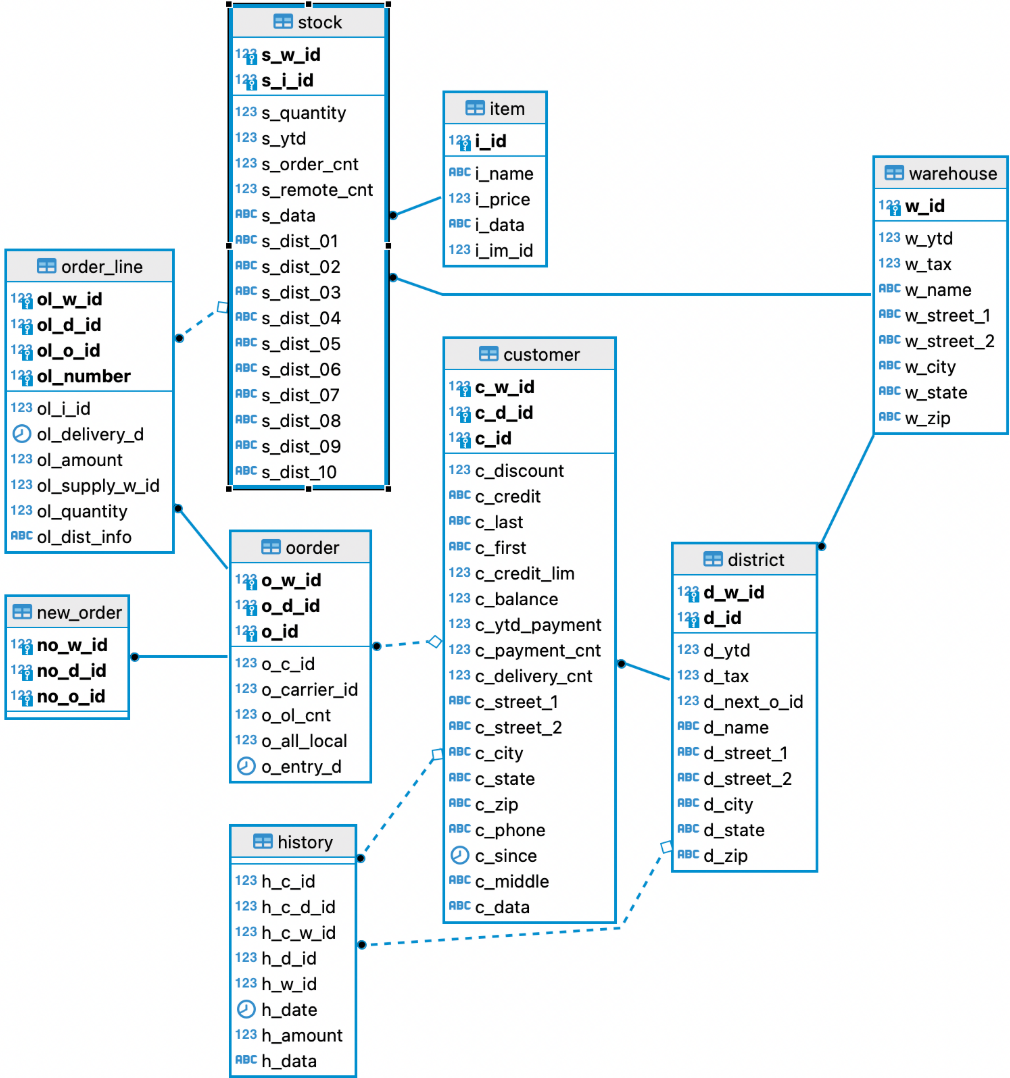
Функция NewOrder — это бизнес-транзакция для выполнения нового заказа с помощью одной транзакции базы данных.
Представляет собой транзакцию чтения-записи среднего веса с высокой частотой выполнения. Эта транзакция является основой рабочей нагрузки.
Позволяет моделировать переменную нагрузку, характерную для оперативной активности базы данных в производственных средах.
Структура транзакции NewOrder
CREATE OR REPLACE FUNCTION benchbase.new_order(w_id smallint, d_id bigint, c_id integer, o_entry_d timestamp without time zone, i_ids integer[], i_w_ids integer[], i_qtys integer[])
 RETURNS benchbase.t_order_res
 LANGUAGE plpgsql
AS $function$
DECLARE
    getWarehouseTaxRate text := 'SELECT W_TAX FROM benchbase.WAREHOUSE WHERE W_ID = $1';
    getDistrict text := 'SELECT D_TAX, nextval(''benchbase.D_NEXT_O_ID'') FROM benchbase.DISTRICT WHERE D_ID = $1 AND D_W_ID = $2';
    getCustomer text := 'SELECT C_DISCOUNT, C_LAST, C_CREDIT FROM benchbase.CUSTOMER WHERE C_W_ID = $1 AND C_D_ID = $2 AND C_ID = $3';
    createOrder text := 'INSERT INTO benchbase.OORDER (O_ID, O_D_ID, O_W_ID, O_C_ID, O_ENTRY_D, O_CARRIER_ID, O_OL_CNT, O_ALL_LOCAL) VALUES ($1, $2, $3, $4, $5, $6, $7, $8)';
    createNewOrder text := 'INSERT INTO benchbase.NEW_ORDER (NO_O_ID, NO_D_ID, NO_W_ID) VALUES ($1, $2, $3)';
    getItemInfo text := 'SELECT I_PRICE, I_NAME, I_DATA FROM benchbase.ITEM WHERE I_ID = $1';
    getStockInfo text := 'SELECT S_QUANTITY, S_DATA, S_YTD, S_ORDER_CNT, S_REMOTE_CNT, S_DIST_%s FROM benchbase.STOCK WHERE S_I_ID = $1 AND S_W_ID = $2';
    updateStock text := 'UPDATE benchbase.STOCK SET S_QUANTITY = $1, S_YTD = $2, S_ORDER_CNT = $3, S_REMOTE_CNT = $4 WHERE S_I_ID = $5 AND S_W_ID = $6';
    createOrderLine text := 'INSERT INTO benchbase.ORDER_LINE (OL_O_ID, OL_D_ID, OL_W_ID, OL_NUMBER, OL_I_ID, OL_SUPPLY_W_ID, OL_DELIVERY_D, OL_QUANTITY, OL_AMOUNT, OL_DIST_INFO) VALUES ($1, $2, $3, $4, $5, $6, $7, $8, $9, $10)';

    all_local boolean := TRUE;
    ol_cnt integer;
    items benchbase.t_order_item[];
    item benchbase.t_order_item;
    customer_info benchbase.t_order_customer;
    c_discount float;
    o_carrier_id integer;
    stock_info benchbase.t_order_stock;
    w_tax float;
    d_tax float;
    d_next_o_id integer;
    brand_generic char;
    ol_amount float;
    total float := 0;
    item_data_s benchbase.t_order_item_data;
    item_data benchbase.t_order_item_data[];
    misc benchbase.t_order_misc;

BEGIN
    ol_cnt = array_length(i_ids, 1);
    ASSERT ol_cnt != 0;
    ASSERT ol_cnt = array_length(i_w_ids, 1);
    ASSERT ol_cnt = array_length(i_qtys, 1);

    FOR i IN 1..ol_cnt LOOP
        all_local = all_local AND i_w_ids[i] = w_id;
        EXECUTE getItemInfo INTO item USING i_ids[i];
        ASSERT item IS NOT NULL;
        items = array_append(items, item);
    END LOOP;
    ASSERT ol_cnt = array_length(items, 1);
    EXECUTE getWarehouseTaxRate INTO w_tax USING w_id;
    EXECUTE getDistrict INTO d_tax, d_next_o_id USING d_id, w_id;
    EXECUTE getCustomer INTO customer_info USING w_id, d_id, c_id;
    c_discount = customer_info.C_DISCOUNT;
    o_carrier_id = 0;
    EXECUTE createOrder USING d_next_o_id, d_id, w_id, c_id, o_entry_d, o_carrier_id, ol_cnt, cast(all_local as integer);
    EXECUTE createNewOrder USING d_next_o_id, d_id, w_id;

    FOR i IN 1..ol_cnt LOOP
        EXECUTE FORMAT(getStockInfo, to_char(d_id, 'FM09')) INTO stock_info USING i_ids[i], i_w_ids[i];
        stock_info.S_YTD = stock_info.S_YTD + i_qtys[i];
        IF stock_info.S_QUANTITY >= i_qtys[i] + 10 THEN
            stock_info.S_QUANTITY = stock_info.S_QUANTITY - i_qtys[i];
        ELSE
            stock_info.S_QUANTITY = stock_info.S_QUANTITY + 91 - i_qtys[i];
        END IF;
        stock_info.S_ORDER_CNT = stock_info.S_ORDER_CNT + 1;

        IF i_w_ids[i] != w_id THEN
            stock_info.S_REMOTE_CNT = stock_info.S_REMOTE_CNT + 1;
        END IF;

        EXECUTE updateStock USING stock_info.S_QUANTITY, stock_info.S_YTD, stock_info.S_ORDER_CNT, stock_info.S_REMOTE_CNT, i_ids[i], i_w_ids[i];

        IF position('ORIGINAL' IN items[i].I_DATA) != 0 AND position('ORIGINAL' IN stock_info.S_DATA) != 0 THEN
            brand_generic = 'B';
        ELSE
            brand_generic = 'G';
        END IF;

        ol_amount = i_qtys[i] * items[i].I_PRICE;
        total = total + ol_amount;
        EXECUTE createOrderLine USING d_next_o_id, d_id, w_id, i, i_ids[i], i_w_ids[i], o_entry_d, i_qtys[i], ol_amount, stock_info.S_DIST;
        item_data_s = ROW(items[i].I_NAME, stock_info.S_QUANTITY, brand_generic, items[i].I_PRICE, ol_amount);
        item_data = array_append(item_data, item_data_s);
    END LOOP;
    total = total * (1 - c_discount) * (1 + w_tax + d_tax);
    misc = ROW(w_tax, d_tax, d_next_o_id, total);
    RETURN ROW(customer_info, misc, item_data);
END;
$function$
;
Вызов функции NewOrder
select benchbase.new_order((CEIL(RANDOM() * 10))::smallint, (CEIL(RANDOM() * 10))::int8, CEIL(RANDOM() * 3000)::integer, current_timestamp::timestamp, ARRAY[CEIL(RANDOM() * 100000)::int], ARRAY[CEIL(RANDOM() * 10)::int], ARRAY[1]);
Схема данных
Тестовые данные
Тестовые данные сгенерированы с помощью BenchBase с использованием бенчмарка TPC-C.
Пример конфигурации для генерации тестовых данных
<?xml version="1.0"?>
<parameters>


    <type>POSTGRES</type>
    <driver>org.postgresql.Driver</driver>
    <url> </url>
    <username> </username>
    <password> </password>
    <reconnectOnConnectionFailure>true</reconnectOnConnectionFailure>


    <isolation>TRANSACTION_READ_COMMITTED</isolation>
    <batchsize>100</batchsize>


    <scalefactor>10</scalefactor>


    <terminals>1000</terminals>
    <works>
        <work>
            <time>1200</time>
            <rate>3000</rate>
            <weights>45,43,4,4,4</weights>
        </work>
    </works>


    <transactiontypes>
        <transactiontype>
            <name>NewOrder</name>
        </transactiontype>
        <transactiontype>
            <name>Payment</name>
        </transactiontype>
        <transactiontype>
            <name>OrderStatus</name>
        </transactiontype>
        <transactiontype>
            <name>Delivery</name>
        </transactiontype>
        <transactiontype>
            <name>StockLevel</name>
        </transactiontype>
    </transactiontypes>
</parameters>
Тестирование базовой конфигурации
grdl.properties
gdl.apply-cache-size=20
gdl.capture-cache-size=12000
gdl.kafka-consumer-queue-size=12000
Параметры модуля применения изменений Applier
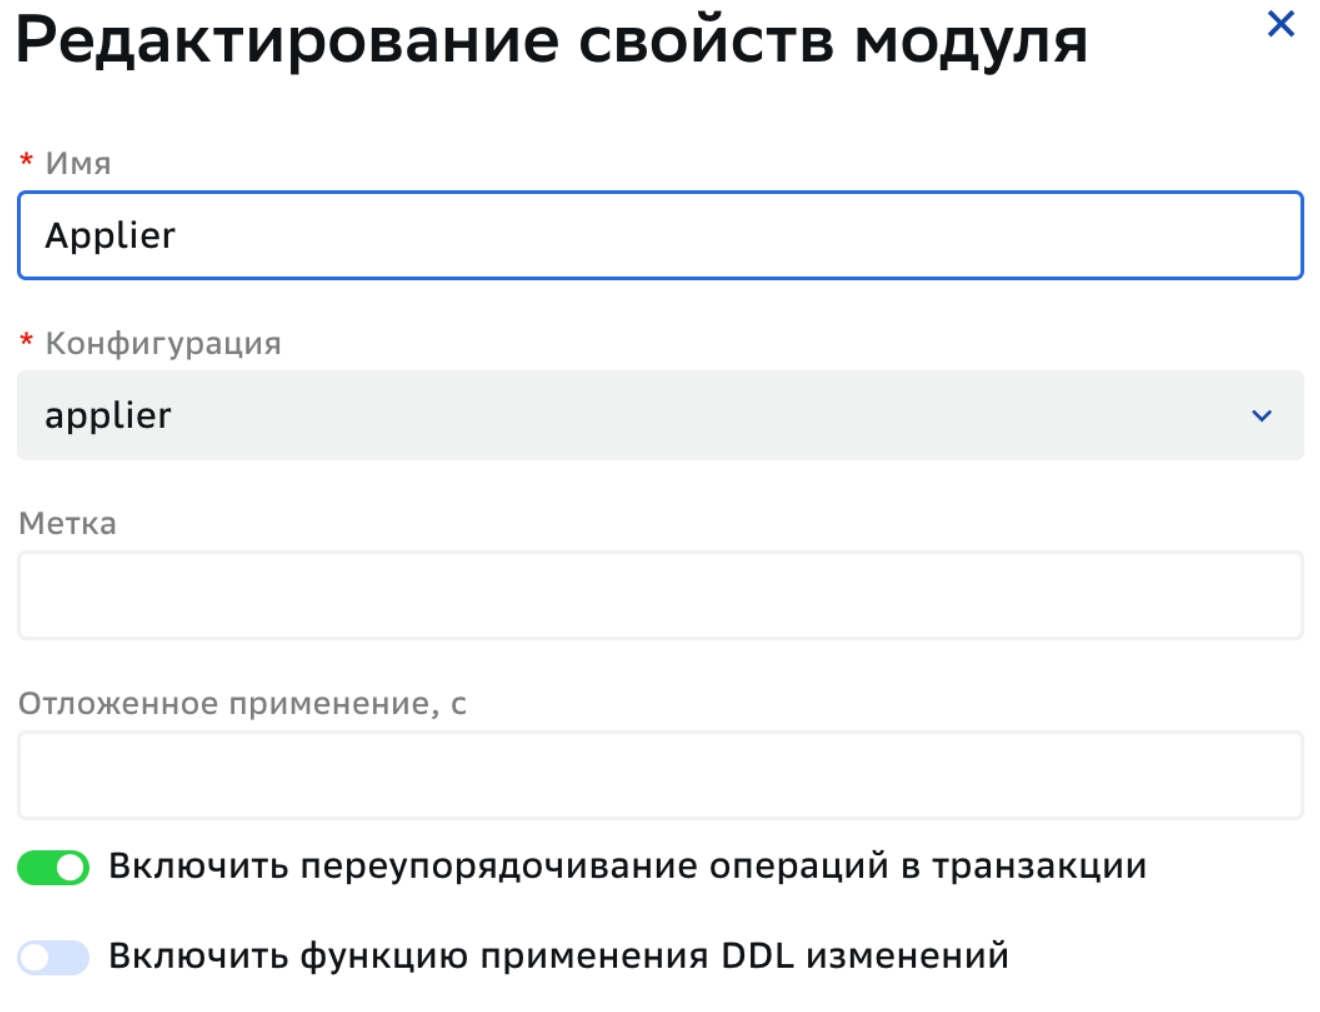
Параметры соединения БД Replica
{
  "max.pool.size": 20,
  "apply.thread.count": 18,
  "transaction.size": 2000,
  "db.linger.ms": 3000
}
Параметры соединения Kafka
{
  "max.poll.records": "1",
  "batch.size": 16384,
  "max.request.size": 209715200,
  "compression.type": "zstd",
  "compression.zstd.level": 3
}
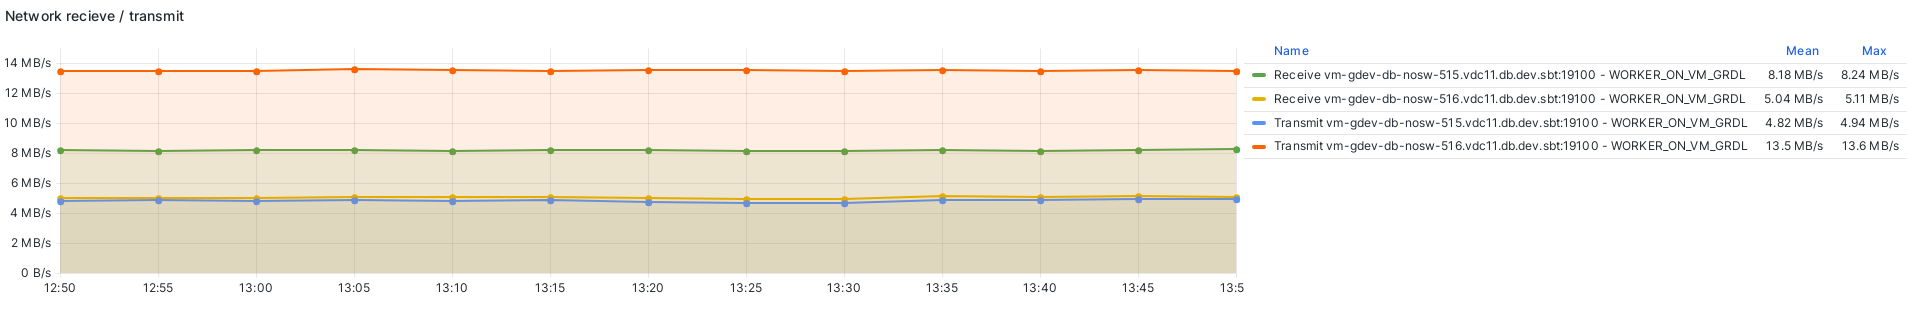
Метрики теста
- Модуль захвата изменений capture:
vm-gdev-db-nosw-515.vdc11.db.dev.sbt - Модуль применения изменений applier:
vm-gdev-db-nosw-516.vdc11.db.dev.sbt
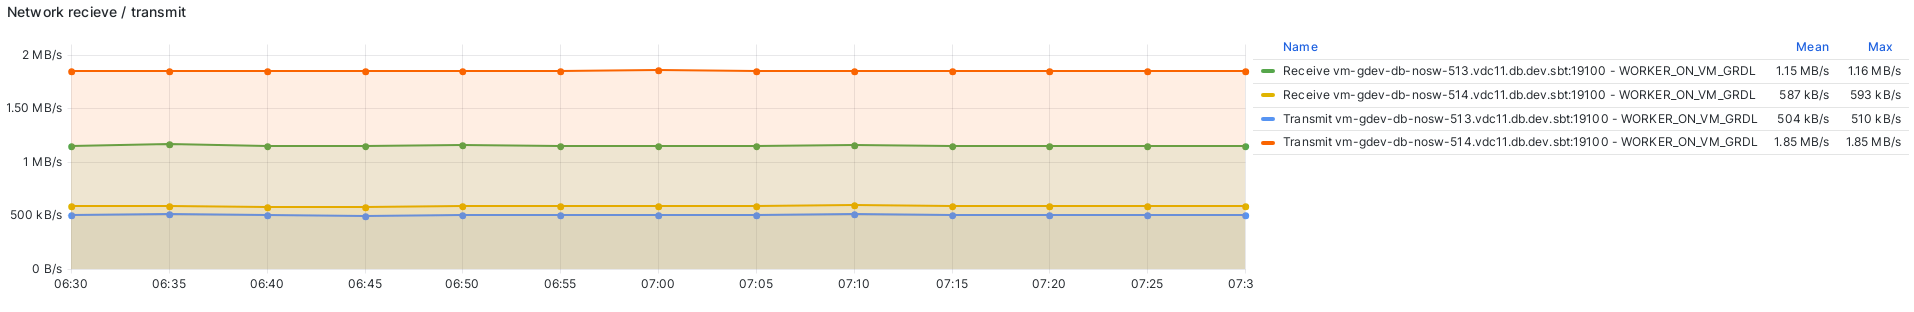
Network recieve/transmit
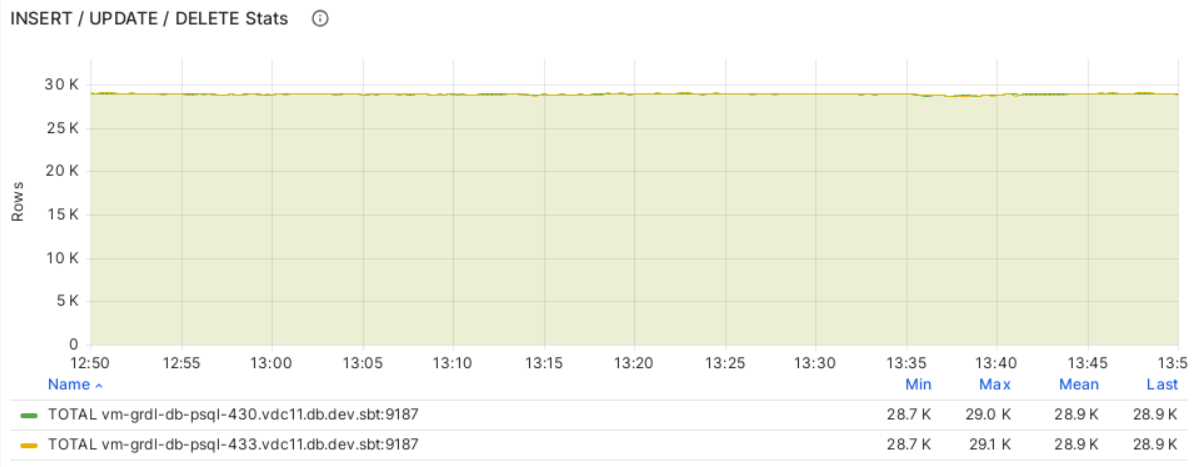
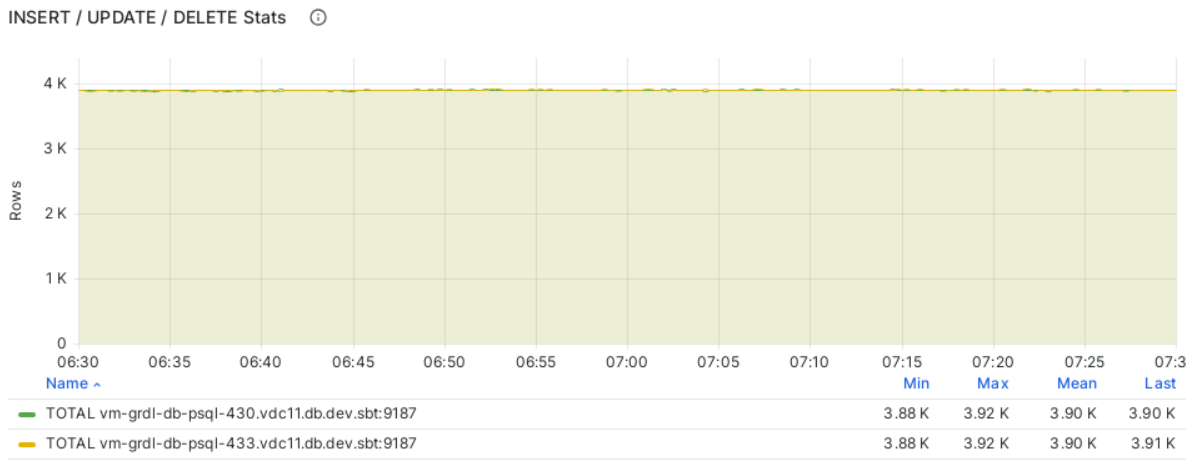
OPS(insert/update/delete)
vm-grdl-db-psql-430.vdc11.db.dev.sbt— БД Sourcevm-grdl-db-psql-433.vdc11.db.dev.sbt— БД Replica
Итог
- Максимальная производительность репликации OPS: 28900
- Максимальная производительность репликации MB/s: 8.2
Тестирование минимальной конфигурации
grdl.properties
gdl.apply-cache-size=20
gdl.capture-cache-size=12000
gdl.kafka-consumer-queue-size=500
Параметры модуля применения изменений Applier
Параметры соединения БД Replica
{
  "max.pool.size": 5,
  "apply.thread.count": 2,
  "transaction.size": 500,
  "db.linger.ms": 1000
}
Параметры соединения Kafka
{
  "max.poll.records": "1",
  "batch.size": 16384,
  "max.request.size": 209715200,
  "compression.type": "zstd",
  "compression.zstd.level": 3
}
Метрики теста
- Модуль захвата изменений capture:
vm-gdev-db-nosw-513.vdc11.db.dev.sbt - Модуль применения изменений applier:
vm-gdev-db-nosw-514.vdc11.db.dev.sbt
Network recieve/transmit
OPS(insert/update/delete)
vm-grdl-db-psql-430.vdc11.db.dev.sbt— БД Sourcevm-grdl-db-psql-433.vdc11.db.dev.sbt— БД Replica
Итог
- Максимальная производительность репликации OPS: 3900
- Максимальная производительность репликации MB/s: 1.15
Рекомендации по настройке очередей
Параметры конфигурации могут быть заданы:
- при установке приложения в среду k8s;
Также параметры конфигурации можно редактировать в ConfigMap уже установленного приложения.
Параметры соединения могут быть заданы в UI консоли GRDL.
Обозначения и типы параметров
1) Параметры ConfigMap модулей GraDeLy (очереди/кэши модулей)
| Параметр | Описание |
|---|---|
capture-cache-size | Размер внутреннего кэша потока pgoutput-сообщений в модуле capture |
consumer-cache-size | Максимальное количество закешированных векторов изменений, готовых к отправке в Kafka |
apply-cache-size | Максимальное количество закешированных векторов изменений, вычитанных из Kafka, но еще не примененных |
2) Параметры БД-приёмника в UI GraDeLy
| Параметр | Описание |
|---|---|
apply.thread.count | Параллелизм применения |
transaction.size | Группировка операций при применении |
3) Расчетные величины (для сайзинга)
| Параметр | Описание |
|---|---|
| op_size_max | Максимальный размер одной операции, МБ (определяется по результатам тестирования) |
| ops_in_tx_max | Максимальное число операций в транзакции (определяется по результатам тестирования) |
Дополнительные расчетные величины (оценки памяти)
Ниже приведены расчетные величины, используемые для оценки потребления памяти отдельными очередями/кэшами модулей GraDeLy.
Это не параметры конфигурации, а производные оценки, вычисляемые по формулам на основе выбранных значений параметров и принятых верхних оценок нагрузки.
| Параметр | Описание |
|---|---|
| mem_capture_cache | Оценка памяти, занимаемой внутренним кэшем потока pgoutput-сообщений в модуле capture, в МБ |
| mem_capture_kafka_queue | Оценка памяти, занимаемой очередью подготовленных векторов изменений в модуле capture (буфер перед отправкой в Kafka), в МБ |
| mem_applier_kafka_queue | Оценка памяти, занимаемой очередью векторов изменений в модуле applier (вычитаны из Kafka, но еще не применены), в МБ |
| mem_apply_cache | Оценка памяти, занимаемой кэшем подготовленных bulk-запросов к БД-приёмнику в модуле applier, в МБ |
Общий подход к настройке параметров
При выборе размеров очередей и кэшей ориентируемся на:
- op_size_max
- ops_in_tx_max
apply.thread.counttransaction.size
Параметры ConfigMap модуля capture
capture-cache-size
Назначение
Размер внутреннего кэша потока pgoutput-сообщений в модуле capture.
Ограничение
capture-cache-size >= 2 * ops_in_tx_max
где ops_in_tx_max - максимальное количество изменений в одной транзакции
Оценка памяти
mem_capture_cache ≈ op_size_max * capture-cache-size
Пример
- op_size_max = 1 МБ
- ops_in_tx_max = 500 →
capture-cache-size= 500 * 2 = 1000 - mem_capture_cache ≈ 1 МБ * 1000 = 1000 МБ (~1 ГБ)
kafka-consumer-queue-size
Назначение
Максимальное количество закешированных векторов изменений, готовых к отправке в Kafka.
Значение должно обеспечивать буферизацию как минимум одной транзакции. Рекомендуемое значение: 100 (стартовая рекомендация).
Оценка памяти
mem_capture_kafka_queue ≈ kafka-consumer-queue-size * op_size_max
Пример
- op_size_max = 1 МБ
kafka-consumer-queue-size= 100- mem_capture_kafka_queue ≈ 100 МБ
Параметры очереди модуля applier
kafka-consumer-queue-size
Назначение
Максимальное количество закешированных векторов изменений, вычитанных из Kafka, но еще не примененных.
Значение должно обеспечивать буферизацию как минимум одной транзакции. Рекомендуемое значение: 100 (стартовая рекомендация).
Оценка памяти
mem_applier_kafka_queue ≈ kafka-consumer-queue-size * op_size_max
Пример
- op_size_max = 1 МБ
kafka-consumer-queue-size= 100- mem_applier_kafka_queue ≈ 100 МБ
apply-cache-size
Назначение
Максимальное количество подготовленных bulk-запросов к БД-реплике, ожидающих выполнения.
Рекомендуемое значение
По одному на поток применения:
apply-cache-size = apply.thread.count
Оценка памяти
mem_apply_cache ≈ apply-cache-size * op_size_max * transaction.size
где transaction.size — размер пачки/группы операций на применение; при этом не меньше одной транзакции источника.
Пример
apply-cache-size= 10 (еслиapply.thread.count= 10)- op_size_max = 10 МБ
transaction.size= 20- mem_apply_cache ≈ 10 * 10 МБ * 20 = 2000 МБ (~2 ГБ)
Практические рекомендации
- Соберите исходные оценки (op_size_max, ops_in_tx_max) на реальных данных.
- Посчитайте память по формулам для каждого кэша/очереди и суммарно.
- Заложите overhead (метаданные векторов изменений, структуры данных, GC): обычно добавляют запас ×2–×10 к расчетному объёму.
- Если упираетесь в память — снижайте в первую очередь:
kafka-consumer-queue-size(с учетом “не меньше 1 транзакции”),- затем аккуратно
transaction.size, - и только потом —
apply.thread.count/apply-cache-size(это уже влияет на пропускную способность).
Пример расчета
Исходные данные
- op_size_max = 2 МБ
- ops_in_tx_max = 300
kafka-consumer-queue-size= 100apply.thread.count= 8transaction.size= 25
Принимаем
capture-cache-size= 2 * ops_in_tx_max = 600apply-cache-size=apply.thread.count= 8
Сapture — итоговая формула и расчет
- mem_capture_total ≈ op_size_max * (
capture-cache-size+kafka-consumer-queue-size) - mem_capture_total ≈ 2 * (600 + 100) = 1400 МБ
Итого для capture:
- ~1400 МБ (~1.4 ГБ)
Суммарно с запасом ×3:
- 4200 МБ
Applier — итоговая формула и расчет
- mem_applier_total ≈ op_size_max * (
kafka-consumer-queue-size+apply-cache-size*transaction.size) - mem_applier_total ≈ 2 * (100 + 8 * 25) = 2 * 300 = 600 МБ
Итого для applier:
- ~600 МБ
Суммарно с запасом ×3:
- 1800 МБ
Настройка механизма для ограничения входящих запросов Rate Limiter
Для Java-based:
Задайте следующие параметры в ConfigMap консоли или воркера:
| Параметр | Тип | Значение по умолчанию | Описание |
|---|---|---|---|
grdl-console.rate-limiter-enabled | boolean | true | Включает и выключает Rate Limiter для консоли |
grdl-console.rate-limiter-metric-prefix | string | grdl_console | Приставка для имени метрики, которая показывает, сколько запросов прошли через Rate Limiter на консоли. Например, при значении по умолчанию полное название метрики будет: grdl_console.rate_limiter.requests |
grdl-console.rate-limiter-buckets | json | [{"uri":"/general", "maxTokens":1000, "refillIntervalSec":1}]} | Конфигурация Rate Limiter для каждого эндпойнта консоли |
grdl-module.rate-limiter-enabled | boolean | false | Включает и выключает Rate Limiter для воркера |
grdl-module.rate-limiter-metric-prefix | string | grdl_module | Приставка для имени метрики, которая показывает, сколько запросов прошли через Rate Limiter на воркере. Например, при значении по-умолчанию полное название метрики будет: grdl_module.rate_limiter.requests |
grdl- module.rate-limiter-buckets | json | [{"uri":"/general", "maxTokens":1000, "refillIntervalSec":1}]} | Конфигурация Rate Limiter для каждого эндпойнта воркера |
Json-конфигурация позволяет точечно определить ограничение по количеству вызовов для каждого эндпойнта.
Эта конфигурация представляет массив объектов, в каждом из которых указывается:
- uri — эндпойнт, который необходимо защитить. Поддерживаются regexp, например,
/module/.*/state. Есть ключевое значение/general, с помощью него все эндпойнты, которые не заданы явно, объединяются в одну группу с общим лимитом; - maxTokens — максимальное количество запросов, которое пользователь разрешает к эндпойнту;
- refillIntervalSec — интервал в секундах, за который доступное количество запросов восстанавливается.
Если maxTokens=1000, а refillIntervalSec=1, пользователь не ждет, пока пройдет секунда, — при каждом запросе увеличиваем доступное количество запросов на величину, пропорциональную прошедшему времени.
Например, если с момента прошлого запроса прошло пол секунды, к доступному лимиту добавляется 500 запросов.
Важно, чтобы этот json представлял из себя одну строку без пробелов.
Для SRLS-based:
Задайте следующие параметры в ConfigMap консоли или воркера:
| Параметр | Тип | Значение по умолчанию | Описание |
|---|---|---|---|
grdl.srls.enabled | boolean | true | Включает и выключает Rate Limiter для консоли |
grdl.k8s.common.srls.base.header | string | iv-user | Название заголовка которая идентифицирует уникального пользователя |
grdl.k8s.common.srls.console.header | string | x-console-srls | Название заголовка которая идентифицирует запросы для API console |
grdl.k8s.common.srls.worker.header | string | x-srls | Название заголовка которая идентифицирует запросы от модулей |
grdl.k8s.istio.ingress.srls.shortname | string | grdl | Дескриптор для определения правил SRLS Rate Limits |
grdl.k8s.globalRateLimit.spec.envoyVersion | string | 1.25 | Версия Envoy для SRLS |
grdl.k8s.common.srls.server | string | `` | Адрес сервиса для подключения к SRLS |
grdl.k8s.common.srls.port | string | 8081 | Порт для подключения к SRLS |
grdl.k8s.common.srls.namespace | string | `` | Namespace k8s SRLS |
grdl.srls.endpoints | json | [{"name":"grdl","shortname":"grdl","overall_limit":10000,"by_header":{"header":"iv-user,x-console-srls,x-srls","value":500,"anon_value": 0,"invokers":{{"header_value":"2","name":"console","value":500},{"header_value":"1","name":"worker","value":500}}}}] | Конфигурация Rate Limiter by header для endpoint консоли |
grdl-console.envoy-cn-enable | boolean | true | Включает и выключает защиту от DDOS для консоли |
grdl-console.envoy-cn-list | string | ^.*solution%.sbt$ | Список доступных доменов, которые не блокируются, через запятую |
Json-конфигурация позволяет гибко настравить Rate Limits для эндпойнтов.
Эта конфигурация представляет массив объектов, которые соотвествуют спецификации SRLS.
В примере, указанном в дистрибутиве - в SRLS ставится дескриптор grdl и любой трафик которые не будет иметь ниодного из заголовков iv-user,x-console-srlsx-srls будет заблокирован, в обратном случее применится общий rate limit - 500 запрос в сек (значение по умолчанию), если один из заголовков будет иметь значение "1" или "2" то квота для него будет пересмотрена.
Защита от DDoS организована через EnvoyFilter lua скриптом, поэтому при формировании списка grdl-console.envoy-cn-list нужно учитывать синтаксис lua (например изоляцию спецсимволов через %), поддерживает регулярные выражения, в значении по умолчанию wildcard для определенных доменов 1 и 2-го уровня.
Bypass некритичных сервисов
GraDeLy выполняет требование по отказоустойчивости при недоступности некритичных сервисов:
-
One-Time Password (OTP) / OTT;
-
Мониторинг (MONA) и журналирование (LOGA).
Внимание!Если мониторинг и журналирование не доступны, информация о событиях записывается в локальное хранилище. Размер локального хранилища зависит от настроек k8s.
После переполнения памяти локального хранилища, консоль перестанет функционировать, но репликация продолжится за счет принципа непрерывности репликации, обеспечиваемого архитектурой GraDeLy.
Непрерывность репликации
Непрерывность репликации GraDeLy при недоступности UI/Консоли/репозитарной БД обеспечивается за счет архитектуры: воркеры работают изолированно друг от друга и от консоли. После создания задачи репликации они выполняют ее до получения следующей команды от консоли.
Гарантированная доставка данных
GraDeLy обеспечивает сохранность, целостность транзакций и защиту данных, в том числе гарантированную доставку, за счет принципа непрерывности репликации и отказоустойчивости Kafka.
Убедиться в полноте транзакционной целостности можно за счет:
Параметра flush_lsn на базе-источнике
flush_lsn, или сброс lsn, внутренней метки (Log Sequence Number), обозначающей позицию в журнале транзакций (WAL), до которой данные уже безопасно переданы и подтверждены, при чтении слота репликации гарантированно происходит, только после получения ответа от Kafka об успешной доставке сообщения в топик.
Параметров acks=all и min.insync.replicas в Kafka
Параметр acks определяет, сколько брокеров должны подтвердить получение сообщения до того, как оно будет считаться успешно записанным.
acks=0: сообщение считается доставленным сразу после отправки, подтверждение от брокера не требуется.acks=1: сообщение подтверждается, когда его принял только лидер партиции.acks=all: сообщение подтверждается только после записи во все актуальные in-sync реплики (ISR).
В версии Kafka >= v3.0 значение acks по умолчанию all.
Параметр min.insync.replicas определяет минимальное количество in-sync реплик, которые должны подтвердить получение сообщения, чтобы оно считалось доставленным.
Например, при min.insync.replicas=2 сообщение считается доставленным, если минимум 2 ISR подтвердили получение данных. Если меньше ISR — продюсеры получат ошибку NotEnoughReplicasException.
Чтобы гарантировать устойчивую доставку сообщений:
- Используйте
acks=all. - Установите
min.insync.replicas ≥ 2на брокере/топике.
В этом случае сообщение будет записано минимум на двух репликах, и если одна из них выйдет из строя — данные не будут потеряны.
Установка min.insync.replicas на уровне брокера
Инструкция для администраторов Kafka
-
Установка параметра
min.insync.replicas:kafka-configs.sh --bootstrap-server localhost:9092 --alter \--entity-type brokers --entity-default \--add-config min.insync.replicas=2 -
Проверьте конфигурации брокера:
kafka-configs.sh --bootstrap-server localhost:9092 --describe \--entity-type brokers --entity-default
Или через файл конфигурации:
Откройте config/server.properties и добавьте:
min.insync.replicas=2
Требуется перезапуск брокера для применения параметра.
Если Kafka не отправляет подтверждение записи модулю Capture
-
Настройте обработчик ошибок следующим образом:
DML_ERROR=ABORT -
При остановке репликации из-за ошибки "Duplicate key value violates unique constraint" или иных ошибок, связанных с нарушением ограничений:
- откройте топик error в Kafka;
- найдите grdl_id сообщения об ошибке;
- запустите модуль Applier с позиции: в качестве типа позиции выберите "gradely", в поле Позиция укажите grdl_id из сообщения об ошибке +1.
При других типах поведения обработчика ошибок на DML_ERROR exactly once доставка не работает. Происходит переход на at least once.
Записи GraDeLyID на базе-приемнике
Идентификатор последней примененной транзакции GraDeLyID записывается в Kafka в столбцы key и value, а также в столбец trx_id технической таблицы $GRADELY_APPLY_POSITION$, которая находится на базе приемника.
Умная балансировка
GraDeLy обеспечивает балансировку нагрузки между узлами за счет проверок работоспособности (healthchecks) прикладной функциональности.
Console предоставляет следующие heatlhchecks:
- Readiness probe: uri -
Settings/isReady; - Liveness probe: uri -
Settings/isActive.
Для Worker внешние healthchecks не требуются, так как ими управляет Console.
В качестве балансировщика нагрузки может использоваться HAProxy или его аналог. Балансировка настраивается по инструкции используемого балансировщика.
Поэтапное обновление GraDeLy
Балансировщик нагрузки и java-based Rate Limiter позволяют контролировать трафик на контуре с новой версией по нагрузке.
Принятие решения об откате или дальнейшей установке происходит по итогам анализа метрик и фона ошибок:
- утилизация CPU и RAM подов приложения не превышает 80%;
- приложение прошло проверку базовой работоспособности.
Проверка базовой работоспособности приложения считается успешной, если:
-
UI консоль доступна;
-
через UI можно редактировать конфигурации, соединения и графы;
-
тестирование конфигураций и соединений проходит успешно.
подсказкаДля экономии ресурсов в средах опытной эксплуатации не создается резервный граф для проверки воркера. Считается, что его работоспособность подтверждается на тестовых стендах. Console — малонагруженный компонент, поэтому достаточно базовой проверки работоспособности.
Промежуток времени между установкой на Stand-By и Master определяет заказчик продукта в зависимости от того, сколько времени ему потребуется на проверку базовой работоспособности приложения.
Для обеспечения надежности сервисов репликации GraDeLy необходимо технологическое окно: развертывание во время минимальной клиентской активности.
В GraDeLy при разработке используется инкрементальный подход для изменения структуры базы данных, где каждое изменение обратно совместимо. Технически это обеспечивается добавлением новых changeset в Liquibase-скрипты.
Благодаря этому дополнительных действий с базой данных, кроме непосредственного исполнения Liquibase-скриптов, при обновлении не требуется.
Базовые метрики Console и Worker
Console передает четыре ключевые метрики:
| Метрика | Техническое название | Единица измерения |
|---|---|---|
| Количество worker, готовых взять задачу (статус READY) | grdl_console_active_worker.count | count |
| Количество worker, выполняющих задачу (статус ACTIVE) | grdl_console_ready_worker.count | count |
| Количество worker, к которым нет доступа (статус DETACHED) | grdl_console_detached_worker.count | count |
| Количество произошедших ошибок | grdl_console_error.count | count |
Worker передает метрики, которые относятся к процессу репликации:
| Метрика | Техническое название | Единица измерения |
|---|---|---|
| Количество транзакций в секунду | grdl_module.tps | count/second |
| Текущий размер очереди из транзакций на источнике | grdl_module.captureCacheSize | count |
| Размер очереди из транзакций на приемнике в момент записи в базу | grdl_module.applyCacheSize | count |
| Размер очереди транзакций на приемнике в момент чтение из Kafka | grdl_module.kafkaConsumerQueueSize | count |
Инфраструктурные метрики
GraDeLy рекомендует настроить получение следующих инфраструктурных метрик для подов с console и worker:
| Метрика | Единица измерения |
|---|---|
| pod CPU | % |
| CPU контейнера в поде | % |
| pod RAM | % |
| RAM контейнера в поде | % |
Порядок поэтапного обновления GraDeLy
Workers обратно совместимы с Console.
Обновление Console не влияет на работающую репликацию.
Обновлять workers можно поэтапно. При обновлении workers не происходит потери данных, но может возникнуть незначительная задержка в репликации, поэтому рекомендуется проводить обновление workers в техническое окно.
Предусловия:
- Обновление происходит при полной работоспособности Master кластера.
- Работает балансировщик нагрузки между кластерами.
Шаги:
- Запустите Liquibase-скрипты для БД с конфигурацией Console.
- Обновите компонент (UI-Console/Worker) на Stand-By кластере.
- Проведите базовую проверку работоспособности компонента на Stand-By кластере.
- Повторите шаги 2 и 3 для Master кластера.
Откат изменений
При обновлении с ошибкой на любом из пунктов основного сценария проводим процедуру отката до предыдущей версии: выполните основной сценарий с последней работоспособной версией.
Поведение GraDeLy при недоступности Kafka или БД
Вне зависимости от причины недоступности БД источника, БД приемника или Kafka, поведение воркеров GraDeLy определяется только установленным обработчиком ошибок.
GraDeLy умеет реагировать на сбои Kafka благодаря обработчику ошибок. Для этого после сохранения схемы графа на все его соединения по умолчанию добавляется обработчик ошибок со следующими параметрами:
- Тип: CONNECTION_ERROR;
- Действие: RETRY;
- Попыток реконнекта: 180;
- Тайм-аут реконнекта (сек): 10.
Режимы обработчика ошибок
abort
- Первая недоступность БД/Kafka приводит к:
- остановке модулей на графе репликации;
- записи ошибки в процессы и логи.
- Репликация не продолжается автоматически.
connection_retry
- При недоступности сервисов выполняются попытки переподключения:
- каждый промежуток, заданный в Тайм-аут реконекта;
- не более, чем число попыток, указанных в Попытках реконекта.
- Если подключение успешно, процесс восстанавливается.
- Если все попытки исчерпаны, сценарий переходит в режим abort.
Сценарии работы
1. Недоступность БД источника (режим connection_retry)
- Capture фиксирует последний commitLsn, полученный из pgoutput.
- Capture пытается переподключаться по схеме: Тайм-аут реконекта × Попытк реконекта.
- При успешном восстановлении соединения:
- Capture переподключается к БД-источнику.
- Продолжает получать изменения из pgoutput с сохраненного commitLsn.
2. Недоступность БД приемника (режим connection_retry)
- Applier выполняет переподключения по схеме: Тайм-аут реконекта × Попыток реконекта.
- При успешном восстановлении соединения:
- Applier продолжает репликацию с следующего offset из "
$GRADELY_APPLY_POSITION$".
- Applier продолжает репликацию с следующего offset из "
3. Недоступность Kafka (режим connection_retry)
- Оба воркера (Capture и Applier) переподключаются по схеме
connection_retry. - Capture фиксирует последний commitLsn, полученный из pgoutput.
- На время простоя Kafka:
- Capture прекращает чтение из pgoutput.
После восстановления Kafka:
- Capture подключается к БД источнику и продолжает получать изменения из pgoutput с сохраненного commitLsn.
- Apply продолжает репликацию с следующего offset из "
$GRADELY_APPLY_POSITION$".
Итог
- abort = остановка при первой же ошибке.
- connection_retry = устойчивый режим: воркеры ждут восстановления сервисов и продолжают с последней сохраненной позиции (
commitLsnилиGRADELY_APPLY_POSITION).
Такой подход позволяет избежать потери транзакций и минимизировать ручное вмешательство при краткосрочных сбоях Kafka или БД.
Запас производительности
Тест надежности
Сценарий тестирования
Тест проводится на уровне нагрузки Lstab = 70% от Lmax. Длительность стабильной нагрузки не менее 24 часов. В ходе теста фиксируются все отклонения от нормального поведения системы, в том числе деградация производительности, утечки.
Ожидаемый результат
Не были нарушены критерии успешности. В ходе теста показатели интенсивности операций и времени отклика были стабильны. Отсутствует утечка ресурсов. В ходе теста наблюдалась хотя бы одна отработка FullGC (если этого не произошло, необходим дополнительный тест на фиксацию утечки памяти). Получен AWR-отчет за 10-минутный интервал теста. На основании AWR-отчета получено подтверждение от архитекторов БД, что тестируемое приложение не оказывает негативного влияния на работу БД.
Повышение производительности
Для повышения производительности в GraDeLy предусмотрена возможность смены порядка транзакций.
GraDeLy оптимизирует порядок транзакций за счет функции reorder. Благодаря ей можно менять порядок команд INSERT, UPDATE, DELETE и объединять их в prepared statements. Смена порядка транзакций повышает скорость записи на 30-50%.
Для использования функции reorder должны быть установлены отложенные ограничения (deferred constraints) (инструкция по настройке приведена в «Руководстве администратора», разделе «Сценарии администрирования», подразделе «Настройка многопоточной репликации»).
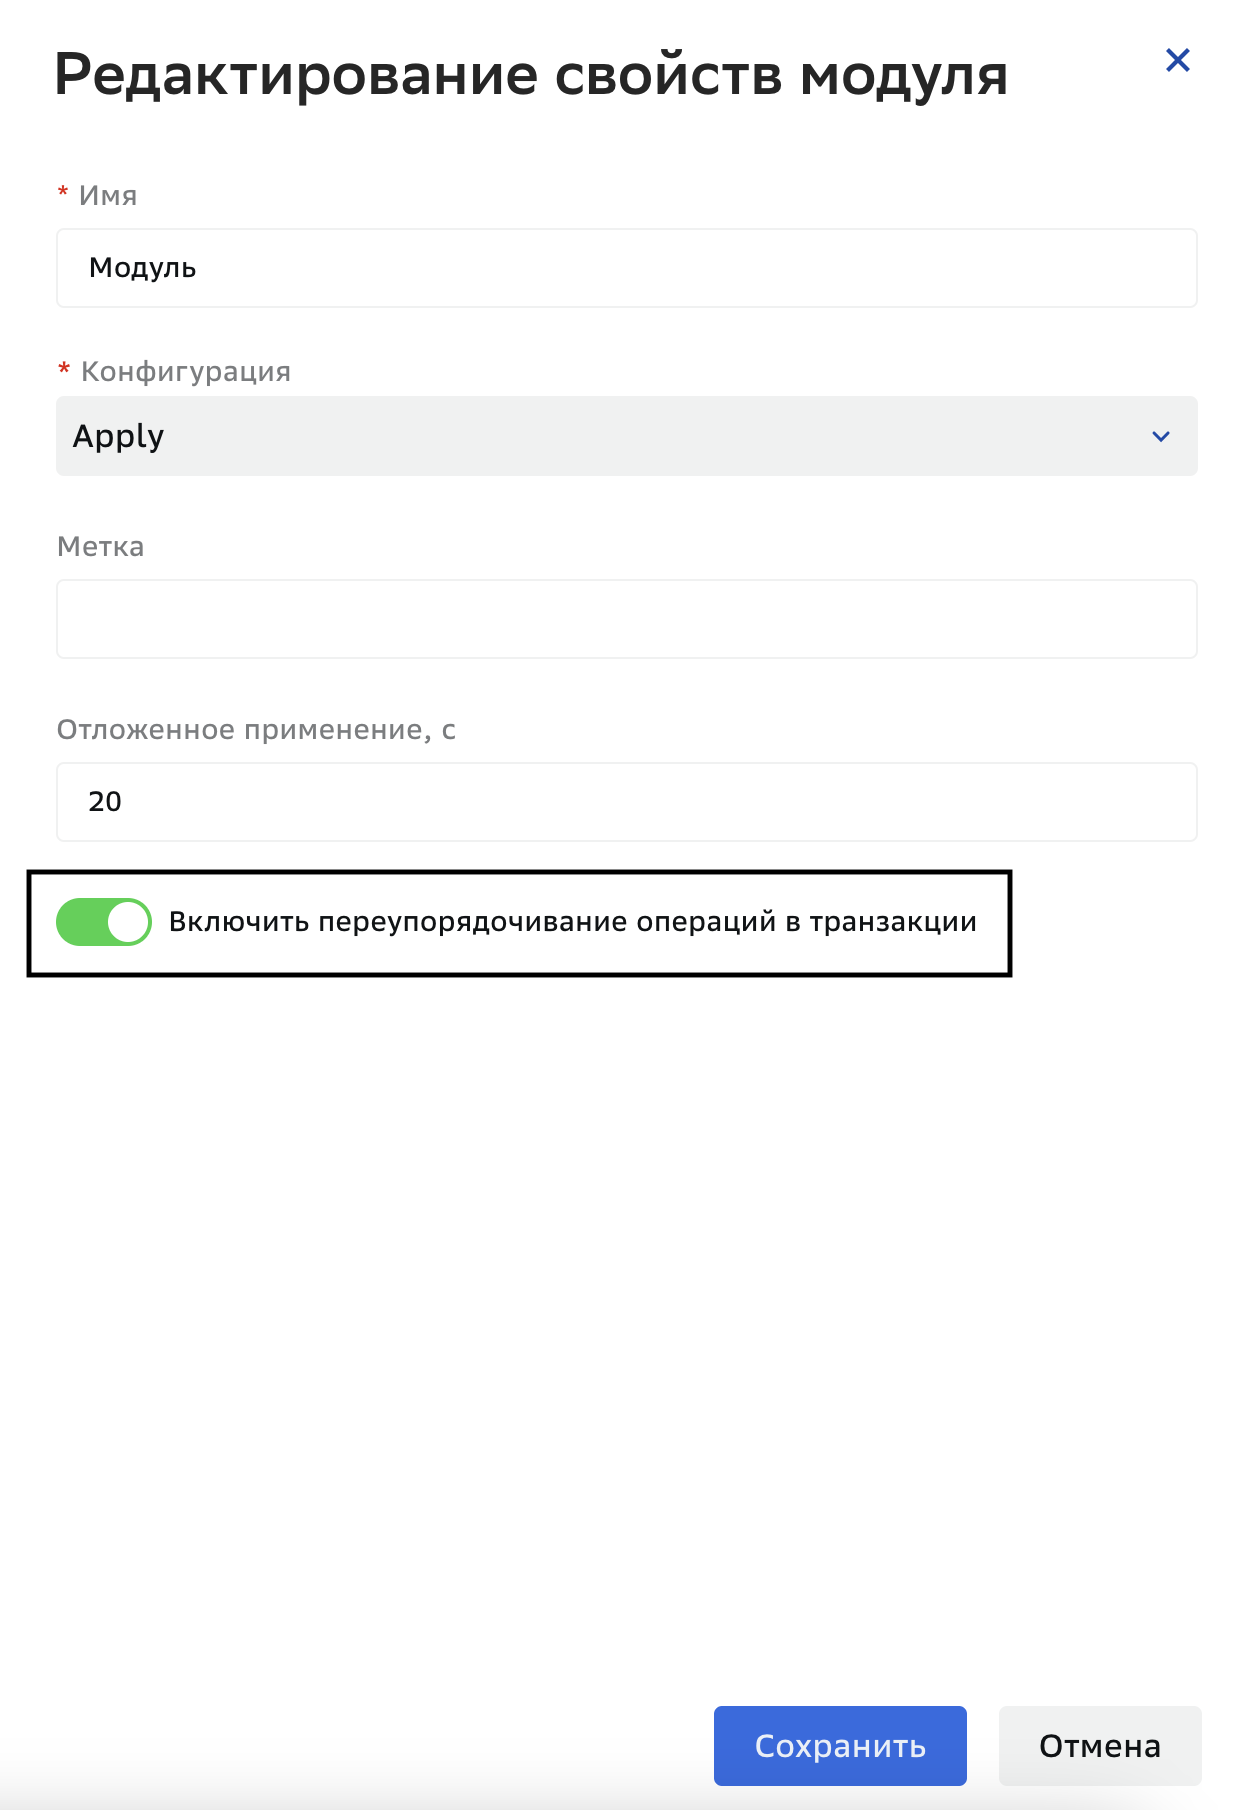
Чтобы включить оптимизацию последовательности транзакций:
По умолчанию "reorder": false, что значит: транзакции идут в том порядке, в котором они были сделаны.
-
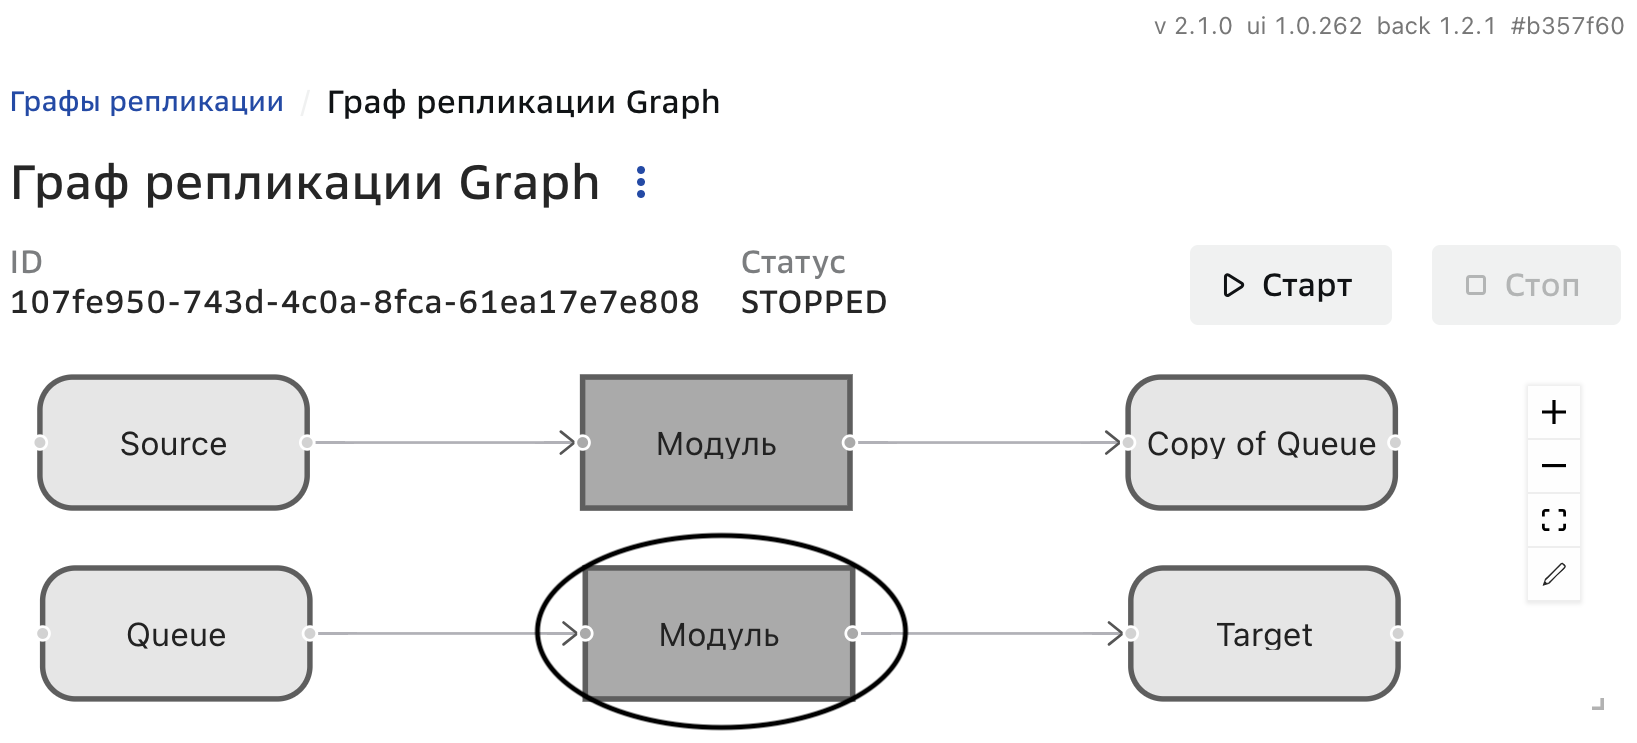
Нажмите модуль на графе.
-
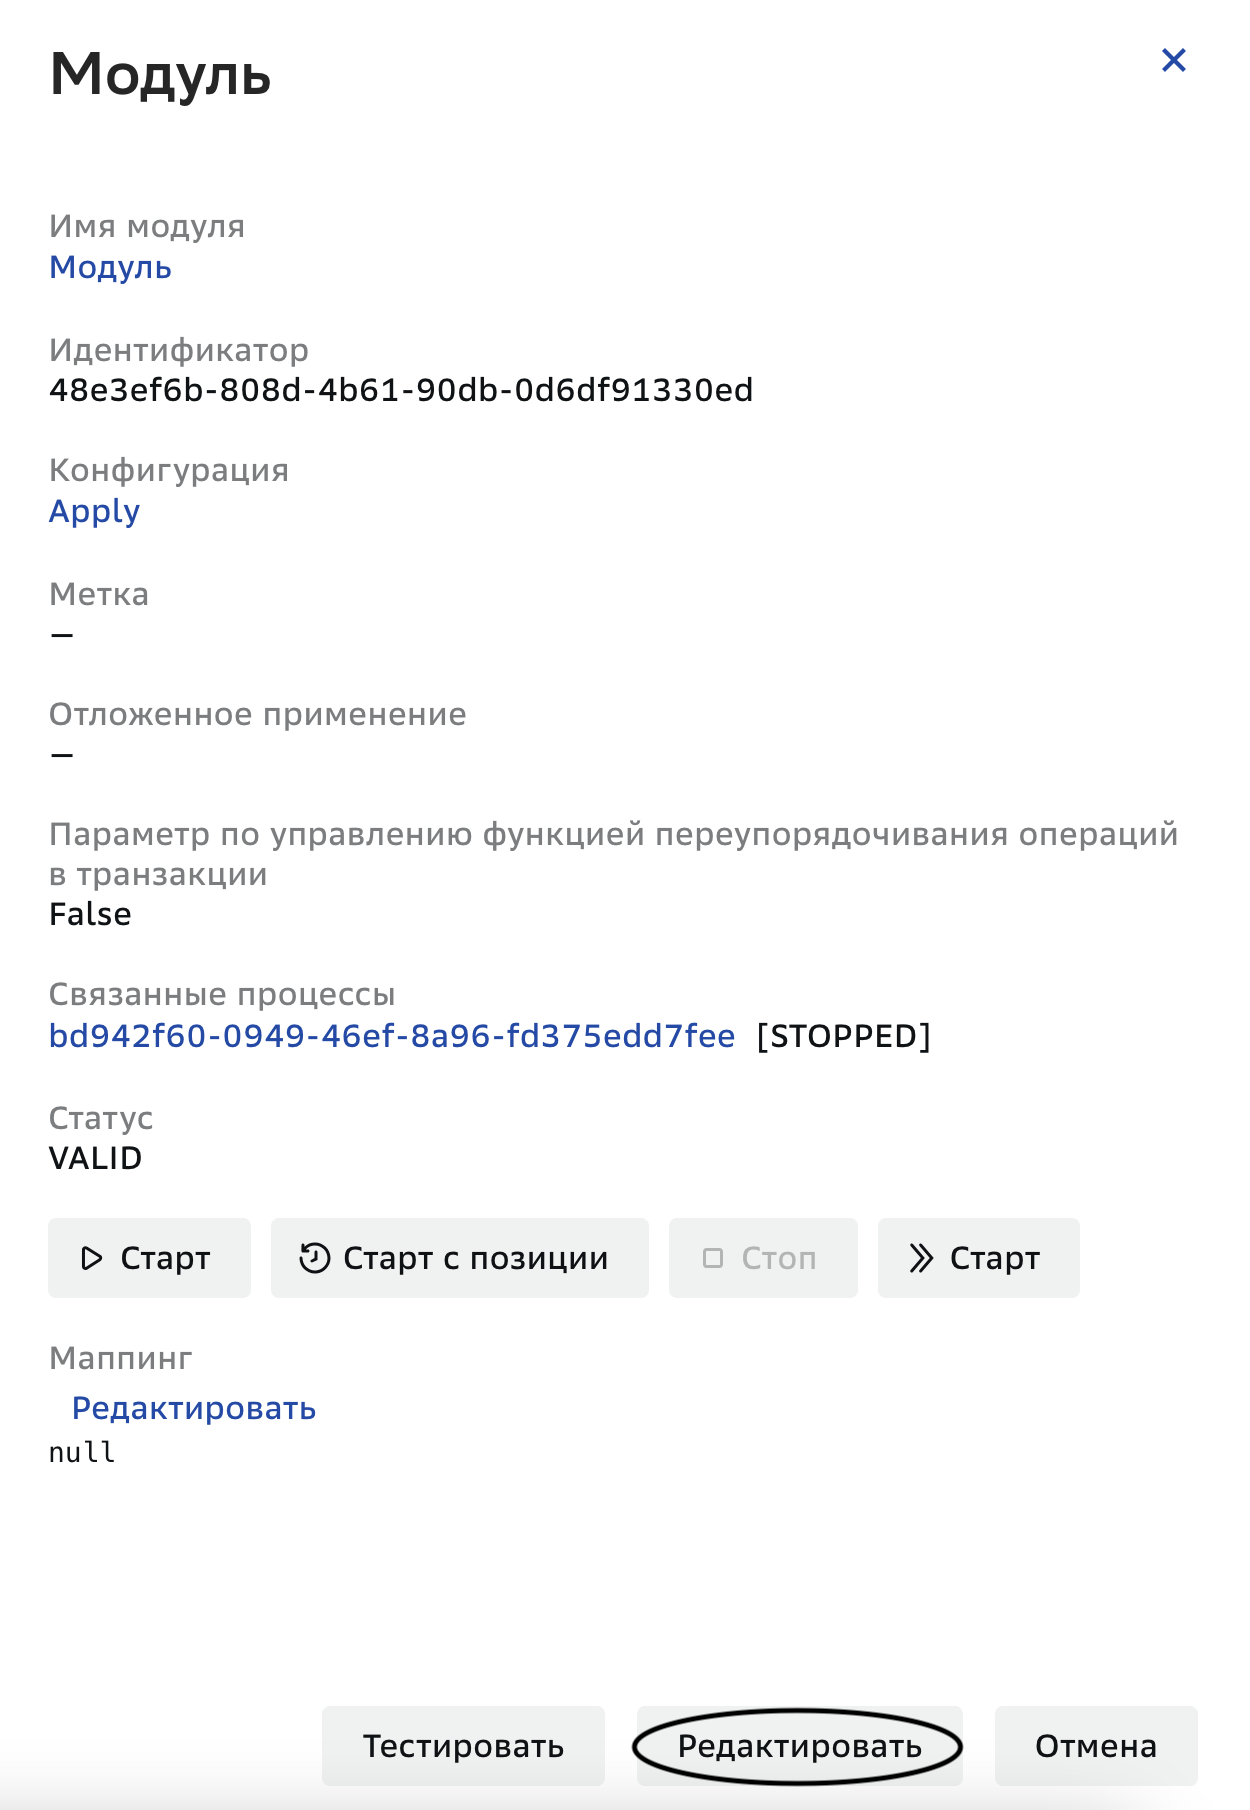
Нажмите Редактировать в открывшемся окне Модуль.
-
Включите переупорядочивание операций в транзакции для оптимизации последовательности транзакций. Смена порядка транзакций повышает скорость записи на 30-50%.
-
Нажмите Сохранить.
Тест подтверждения максимальной нагрузки
Сценарий тестирования
Тест проводится на ступени нагрузки, предшествующей L0 (или на уровне нагрузки 90% от L0). Длительность стабильной нагрузки не менее 1 часа. Если в процессе тестирования система оказалась недогружена или перегружена, то значение нагрузки корректируется и второй тест проводится повторно. В случае увеличения нагрузки новый уровень может быть рассчитан на основе данных об утилизации ресурсов.
Ожидаемый результат
В ходе теста зафиксирован максимальный достигнутый уровень нагрузки Lmax.
Работа GraDeLy с PostgreSQL в кластерном режиме
Console поддерживает работу с PostgreSQL в кластерном режиме по умолчанию. Для работы воркера в кластерном режиме нужно в настройках соединения с БД изменить строку подключения по следующему шаблону (смотрите раздел Настройка соединения в Руководстве пользователя интерфейса консоли управления):
jdbc:postgresql://host1:port1,host2:port2c/database?preferQueryMode=simple&targetServerType=primary
Если не задать "jdbc:postgresql://host1:port1,host2:port2c/database?targetServerType=primary", при старте графа воркеры упадут с ошибками.
Обязательные параметры для работы с PostgreSQL в кластерном режиме:
-
host1:port1- адрес узла кластера; -
host2:port2- адрес следующего узла кластера; -
preferQueryMode- режим запросов к БД, ставитсяsimple;Внимание!- Возможен только
simple; extended,extended_cache_everything,extended_for_preparedневозможны.
Параметр
preferQueryModeопциональный: его нужно прописать для работы в кластерном режиме. Этот режим запросов к БД немного снижает производительность, поэтому используйте его, только если хотите реплицировать из кластера. - Возможен только
-
targetServerType- роль участника кластера, ставитсяprimary.
Для бесперебойной репликации после сохранения схемы графа на все его соединения по умолчанию добавляется обработчик ошибок со следующими параметрами:
- Тип: CONNECTION_ERROR;
- Действие: RETRY;
- Попыток реконнекта: 180;
- Тайм-аут реконнекта (сек): 10.
Резервирование и отказоустойчивость
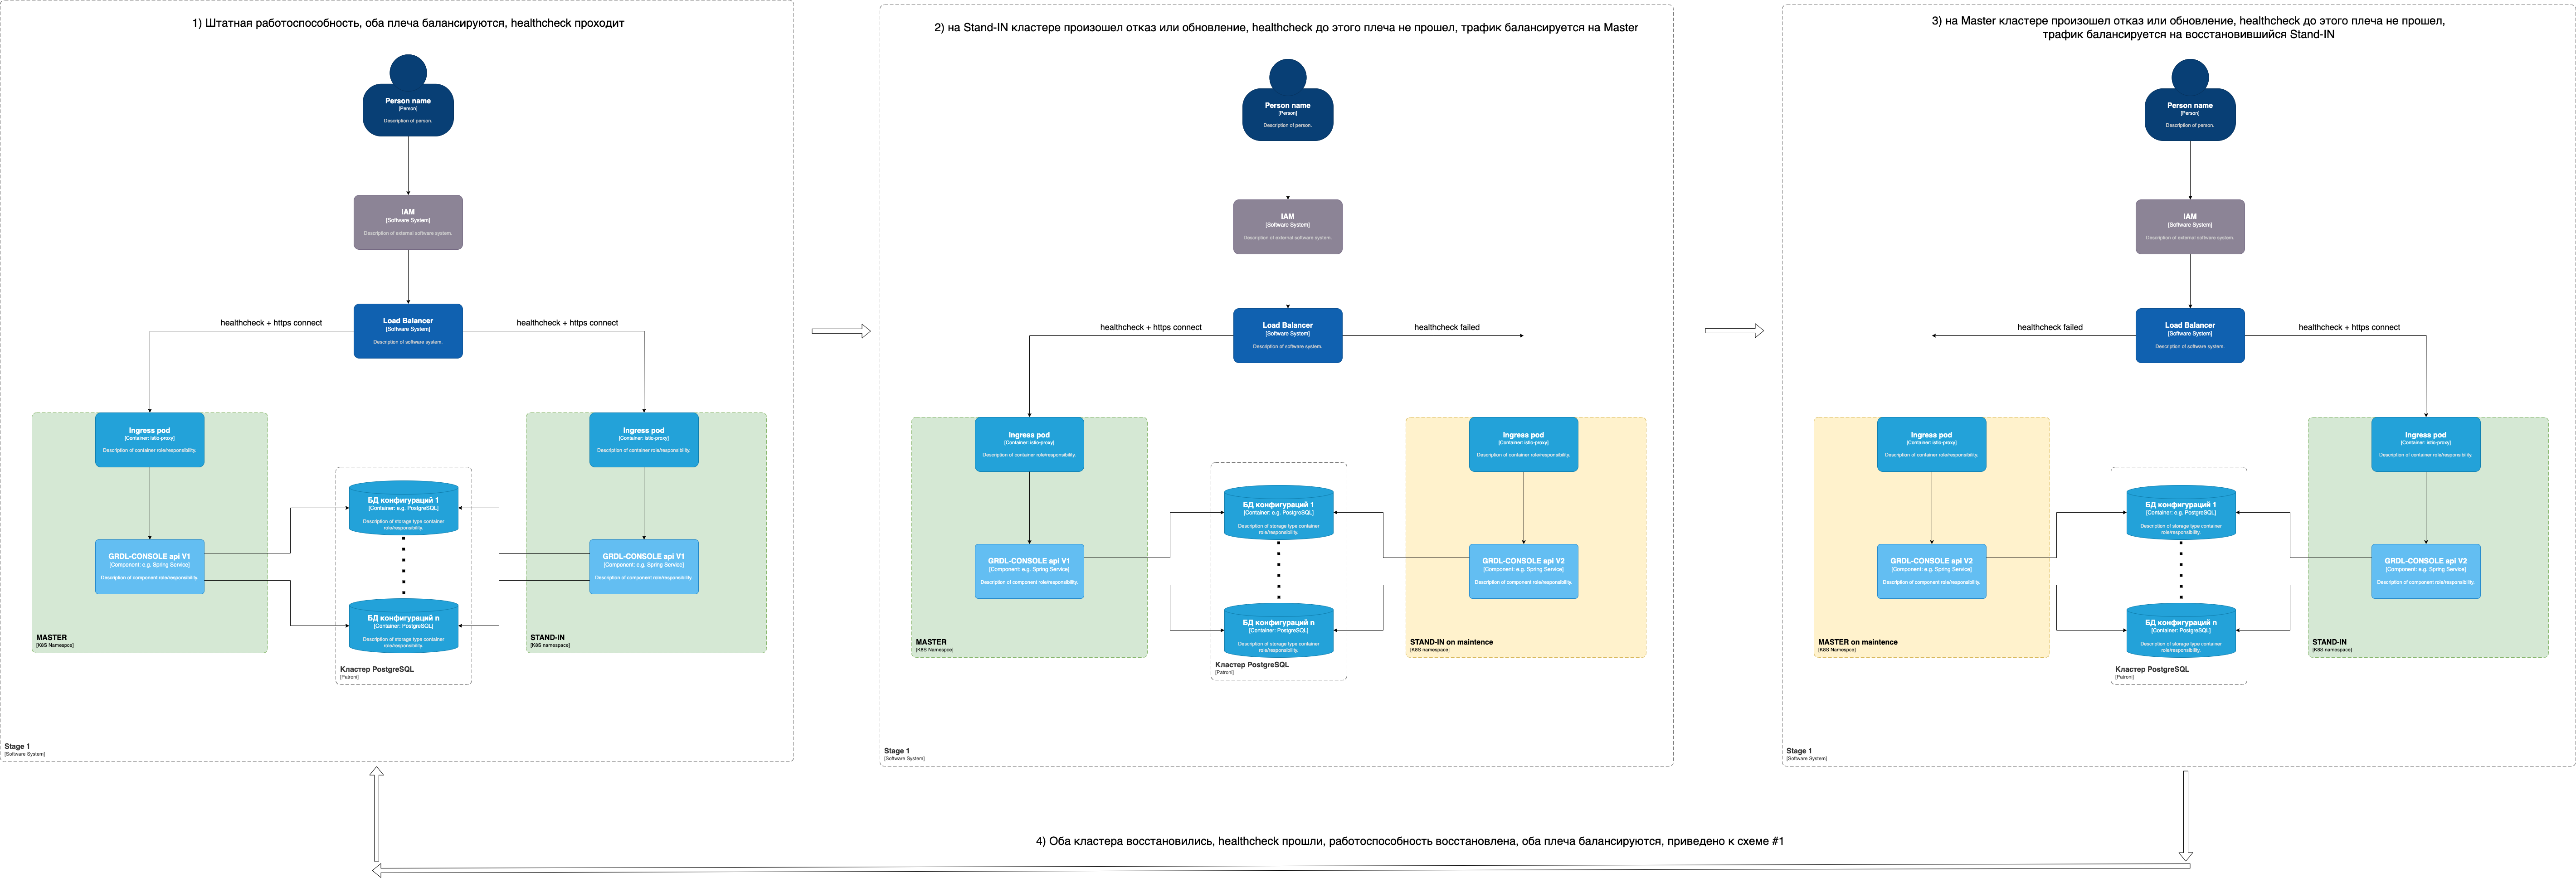
Отказоустойчивость GraDeLy обеспечивается благодаря работе в более чем одном кластере для консоли администратора (UI) и консоли управления (console), и модуля захвата и применения (worker) только в рамках одного кластера через масштабирование Deployment.
Схема, отображающая отказоустойчивость и поэтапное обновление консоли:
Схема для UI аналогична за исключением подключения к БД.
Console
UI и Console работают в режиме Active-Active: один экземпляр разворачивается в DropApp кластер Master, а другой — в DropApp кластер Stand-by.
Все запросы к UI и Console обрабатываются балансировщиком, который на основе анализа healthcheck отправляет запрос на доступный кластер.
Все экземпляры Console работают с кластером БД Patroni, который воспринимается как единая БД, где хранятся данные для настроек правил репликации.
Worker
Workers работают в режиме Active-Passive: одни экземпляры развертываются в DropApp кластер Master, а другие — в DropApp кластер Stand-by.
Все запросы к worker обрабатываются консолью, выполняющей роль балансировщика, в том же кластере, таким образом:
- при доступности Master работают консоли Master и Stand-by, и они отправляет запросы на Master workers;
- при недоступности Master работает консоль Stand-by и отправляет запросы на Master Stand-by.
Все экземпляры worker работают с кластером Kafka и имеют конфигурационный параметр, указывающий на кластер, в котором они работают.
Алгоритм работы при сбое Worker
При выходе из строя worker происходит попытка самовосстановления через обработчик ошибок из Master-кластера.
Если worker не может восстановиться, все доступные на момент консоли из Master и Stand-by регистрируют его сбой.
Если в Master остались свободные workers, одному из них console назначает задачу вышедшего из строя worker.
Если весь Master недоступен или в нем не осталось свободных workers, доступная console назначает worker из Stand-by кластера задачу вышедшего из строя worker.
Восстановление Master
Если worker из Stand-by кластера включился в репликацию из-за недоступности worker из Master, он продолжает работу даже после восстановления работоспособности worker из Master.
Обратное переключение производится вручную, после того как администраторы убедятся в работоспособности кластера.
Резервирование и отказоустойчивость СУБД
Резервирование и отказоустойчивость СУБД обеспечивается за счет поддержки работы Console с Patroni-кластером PostgreSQL.
Полнота мониторинга на оперативном дашборде
Полнота мониторинга на оперативном дашборде обеспечивается за счет передачи бизнес-метрик с Console и Worker, описанных в разделе «Поэтапное обновление GraDeLy».
Наличие включенной ротации сертификатов
Ротация сертификатов контролируется со стороны администраторов инфраструктуры. Со стороны GraDeLy для работы с секретами используется vault-агент.
Обеспечение минимального набора реплик pod
GraDeLy автоматически не определяет, сколько реплик понадобится для его работы. Число реплик настраивается при развертывании приложения:
- для Worker — 1 под на 1 модуль графа;
- для Console — минимальное количество подов определяется на основе НТ тестов.
Использование liveness probe и readiness probe
В Console GraDeLy есть стандартные пробы:
- Readiness probe: uri -
Settings/isReady; - Liveness probe: uri -
Settings/isActive.
Запрет доступа одной АС к БД другой АС
На сетевом уровне подключение к БД происходит по fqdn с сертификатами из HashiCorp Vault. На логическом уровне по логину и паролю из HashiCorp Vault. Запрет доступа осуществляется за счет контроля доступа команд к секретам друг друга со стороны администраторов.
Требование по георезервированию
Георезервирование полностью настраивается администраторами инфраструктуры. Со стороны GraDeLy специфических ограничений или требований нет, так как GraDeLy работает со всеми базами по одному принципу.
Обработка ошибок CONSTRAINT VIOLATION
При применении изменений из trail-файла к реплике может произойти ошибка — например, при попытке вставить дублирующую строку, удалить строку, на которую ссылается другая таблица, или записать недопустимое значение.
- Нарушение первичного ключа (PK) — например, вставка уже существующего ключа.
- Нарушение внешнего ключа (FK) — Попытка вставить ссылку на несуществующий ключ (INSERT, UPDATE) или попытка удалить из родительской таблицы ключ, на который есть ссылка в дочерней таблице.
- Невыполнение проверок — недопустимое или отсутствующее значение, которое не проходит проверку типа CHECK (включая NOT NULL).
Ошибки обрабатываются через обработчик ошибок, привязанный к модулю.
Ошибочные транзакции сохраняются в отдельное хранилище — теневую таблицу $CONFLICT_RESOLUTION_TX$.
Для создания таблицы пропишите и выполните в редакторе СУБД SQL-скрипт:
CREATE TABLE <schema_name>."$CONFLICT_RESOLUTION_TX$" (
source_id int8 NOT NULL,
gradely_id int8 NOT NULL,
change_vector_seq int4 NOT NULL,
transaction_id int8 NOT NULL,
table_schema varchar(128) NOT NULL,
table_name varchar(128) NOT NULL,
opcode bpchar(1) NOT NULL,
error_code bpchar(1) NOT NULL,
error_message text NULL,
vector_data jsonb NOT NULL,
error_handle_action bpchar(1) NOT NULL,
process_id uuid NOT NULL,
created_at timestamp NOT NULL,
CONSTRAINT "$CONFLICT_RESOLUTION_TX$_pkey" PRIMARY KEY (source_id, gradely_id, change_vector_seq)
);
Ошибочные транзакции сохраняются в теневой таблице, если в поле options для соединения базы данных параметр save.skipped.tx.to.db: true.
По умолчанию save.skipped.tx.to.db: true.
По умолчанию таблица находится в схеме grdl.
Структура технической таблицы:
| Колонка | Тип | Описание |
|---|---|---|
| source_id | bigint | ID базы-источника |
| gradely_id | bigint | внутренний ID транзакции GraDeLy |
| change_vector_seq | int | порядковый номер вектора изменений в транзакции |
| transaction_id | bigint | ID транзакции |
| table_schema | varchar(128) | Схема таблицей-приемником |
| table_name | varchar(128) | Название таблицы-приемника |
| opcode | char(1) | Операция (I, U, D) |
| error_code | char(1) | Тип ошибки (F — нарушение внешнего ключа, P — нарушение первичного ключа, C — нарушение проверки значений) |
| error_message | varchar2(256) | Человекочитаемое описание ошибки |
| vector_data | json | JSON с содержимым вектора |
| error_handle_action | char(1) | Тип реакции на ошибку ( A — ABORT, C — CONTINUE) |
Если указаны кластер и топик, GraDeLy может также сохранять ошибочные векторы в Kafka.
Ошибочные транзакции сохраняются в Kafka topic, если в поле options для соединения базы данных параметр save.skipped.tx.to.kafka: true.
По умолчанию save.skipped.tx.to.kafka: false.
Структура сообщения об ошибке в Kafka topic:
openapi: 3.1.0
info:
  title: Error message for REP020
  description: Структура сообщения об ошибке
  version: 0.0.1
paths:
  /:
    description: Фиктивный path
components:
  schemas:
    LogMessage:
      description: JSON, который записывается в поле сообщения
      type: object
      properties:
        gradely_id:
          description: Идентификатор транзакции, в которой произошла ошибка
          type: integer
          format: int64
          minimum: 1
          maximum: 9223372036854775807
          example: 83487
        source_id:
          description: Источник, из которого пришло изменение
          type: integer
          format: int64
          minimum: -9223372036854775808
          maximum: 9223372036854775807
          example: 87238507
        opcode:
          description: Код операции
          type: string
          enum: [ I, U, D ]
        exception:
          description: Ошибка, полученная драйвером jdbc
          type: object
          properties:
            sql_state:
              description: SQLException.getSQLState()
              type: string
              maxLength: 5
              example: 0A000
            vendor_code:
              description: SQLException.getErrorCode()
              type: integer
              minimum: -9223372036854775808
              maximum: 9223372036854775807
              example: 600
          additionalProperties: false
        vector:
          description: Вектор изменений
          type: object
          additionalProperties:
            description: Описание полей
            type: string
            maxLength: 128
            example: The event description
      required: [ gradely_id, source_id, opcode, exception, vector ]
      additionalProperties: false
Коэффициент объёма WAL к объёму данных на Kafka
Цель
Получить практический коэффициент, который связывает объем WAL, проходящий через логический слот PG, с приростом занятого диска Kafka. Коэффициент используется для расчета требуемого диска Kafka под retention.
Коэффициент рассчитывается для воркеров потоков репликации.
Определения
-
WAL_slot_diff — объем WAL в байтах, соответствующий прогрессу логического слота, измеряется как разница
confirmed_flush_lsnперед началом теста и после его окончания.select confirmed_flush_lsn lsn1 from pg_replication_slots; -- Перед началом тестаselect confirmed_flush_lsn lsn2 from pg_replication_slots; -- После окончания тестаselect lsn2::pg_lsn - lsn1::pg_lsn; -
kafka_disk_diff — прирост физического объема файлов Kafka на диске для data-топика.
du -sb /KAFKADATA/demo-* -- Перед началом тестаdu -sb /KAFKADATA/demo-* -- После окончания теста -
W / K — сколько WAL приходится на 1 байт Kafka на диске.
-
K / W — сколько диска Kafka получается на 1 байт WAL.
Методика измерения
Значения параметров по умолчанию, влияющие на измерение коэффициентов
PG:
wal_compression = off
Kafka:
batch.size = 16384
compression.type = zstd
compression.level = 3
Набор тестов и их смысл
Тесты разбиты на 3 группы:
-
Best-case — данные максимально сжимаемы.
-
DDL:
CREATE TABLE compression_test.best_case (id bigint PRIMARY KEY GENERATED ALWAYS AS IDENTITY,tenant_id smallint NOT NULL,payload text NOT NULL);CREATE OR REPLACE PROCEDURE compression_test.best_case_proc(p_target_mb int DEFAULT 1024,p_payload_len int DEFAULT 960,p_rows_per_tx int DEFAULT 1)LANGUAGE plpgsqlAS $$DECLAREtarget_bytes bigint := p_target_mb::bigint * 1024 * 1024;i bigint := 0;j int;BEGINLOOPEXIT WHEN pg_table_size('compression_test.best_case'::regclass) >= target_bytes;FOR j IN 1..p_rows_per_tx LOOPi := i + 1;INSERT INTO compression_test.best_case(tenant_id, payload)VALUES (((i - 1) % 10 + 1)::smallint, repeat('A', p_payload_len));END LOOP;COMMIT;END LOOP;END;$$; -
Best-1: мелкие транзакции (1 row/tx), короткий payload:
CALL compression_test.best_case_proc(p_target_mb => 1024,p_payload_len => 960,p_rows_per_tx => 1); -
Best-2: крупные транзакции (1024 rows/tx), короткий payload
CALL compression_test.best_case_proc(p_target_mb => 1024,p_payload_len => 960,p_rows_per_tx => 1024); -
Best-3: мелкие транзакции (1 row/tx), очень длинный payload(TOAST)
CALL compression_test.best_case_proc(p_target_mb => 1024,p_payload_len => 960000,p_rows_per_tx => 1);
-
-
Worst-case — данные максимально несжимаемы.
-
DDL:
CREATE TABLE compression_test.worst_case (id bigint PRIMARY KEY GENERATED ALWAYS AS IDENTITY,tenant_id smallint NOT NULL,payload text NOT NULL);CREATE OR REPLACE PROCEDURE compression_test.worst_case_proc(p_target_mb int DEFAULT 1024,p_payload_len int DEFAULT 960,p_rows_per_tx int DEFAULT 1,p_table regclass DEFAULT 'compression_test.worst_case'::regclass)LANGUAGE plpgsqlAS $$DECLAREtarget_bytes bigint := p_target_mb::bigint * 1024 * 1024;i bigint := 0;j int;tenant smallint;BEGINIF p_rows_per_tx < 1 THENRAISE EXCEPTION 'p_rows_per_tx must be >= 1';END IF;LOOPEXIT WHEN pg_table_size(p_table) >= target_bytes;FOR j IN 1..p_rows_per_tx LOOPi := i + 1;tenant := ((i * 7919) % 30000 + 1)::smallint;INSERT INTO compression_test.worst_case(tenant_id, payload)VALUES (tenant, substr(encode(compression_test.gen_random_bytes((p_payload_len + 1) / 2), 'hex'), 1, p_payload_len));END LOOP;COMMIT;END LOOP;END;$$;CREATE OR REPLACE PROCEDURE compression_test.worst_case_toast_proc(p_target_mb int DEFAULT 1024,p_payload_len int DEFAULT 960,p_rows_per_tx int DEFAULT 1,p_table regclass DEFAULT 'compression_test.worst_case'::regclass)LANGUAGE plpgsqlAS $$DECLAREtarget_bytes bigint := p_target_mb::bigint * 1024 * 1024;i bigint := 0;j int;tenant smallint;BEGINIF p_rows_per_tx < 1 THENRAISE EXCEPTION 'p_rows_per_tx must be >= 1';END IF;LOOPEXIT WHEN pg_table_size(p_table) >= target_bytes;FOR j IN 1..p_rows_per_tx LOOPi := i + 1;tenant := ((i * 7919) % 30000 + 1)::smallint;INSERT INTO compression_test.worst_case(tenant_id, payload)VALUES (tenant,(SELECT substr(string_agg(encode(compression_test.gen_random_bytes(chunk_bytes), 'hex'),'' ORDER BY idx),1,p_payload_len)FROM (SELECTgs AS idx,LEAST(1024, need_bytes - gs * 1024) AS chunk_bytesFROM (SELECT ((p_payload_len + 1) / 2)::int AS need_bytes) nb,generate_series(0, (nb.need_bytes - 1) / 1024) gs) s));END LOOP;COMMIT;END LOOP;END;$$; -
Worst-1: мелкие транзакции (1 row/tx), payload ≈960:
CALL compression_test.worst_case_proc(p_target_mb => 1024,p_payload_len => 960,p_rows_per_tx => 1); -
Worst-2: крупные транзакции (1024 rows/tx), payload ≈960:
CALL compression_test.worst_case_proc(p_target_mb => 1024,p_payload_len => 960,p_rows_per_tx => 1024); -
Worst-3: мелкие транзакции (1 row/tx), очень длинный payload (TOAST):
CALL compression_test.worst_case_toast_proc(p_target_mb => 1024,p_payload_len => 960000,p_rows_per_tx => 1);
-
-
pgbench — приближение к "типичному OLTP".
-
Тестовые данные (не реплицируются):
pgbench -i -s 100 -I dtGvp \-d "host= port= dbname= user=" -
Запуск теста:
pgbench -T 600 -c 16 -j 4 -M prepared -P 10 \-d "host= port= dbname= user="
-
Цель набора тестов — получить диапазон C:
- C_best (нижняя граница);
- C_worst (верхняя граница);
- C_typical (реалистичная опора).
Результаты тестирования
| Сценарий | Количество сообщений | WAL, MiB | Kafka demo-0 delta, MiB | K / W | W / K |
|---|---|---|---|---|---|
| Best-1 (A×960, 1 row/tx) | 1,049,452 | 1179.93 | 259.09 | 0.2196 | 4.55 |
| Best-2 (A×960, 1024 rows/tx) | 1,024 | 1131.95 | 7.03 | 0.0062 | 161.01 |
| Best-3 (A×960000, 1 row/tx) | 85,987 | 1120.00 | 24.69 | 0.0220 | 45.35 |
| Worst-1 (random×960, 1 row/tx) | 1,048,281 | 1184.00 | 836.30 | 0.7063 | 1.42 |
| Worst-2 (random×960, 1024 rows/tx) | 1,024 | 1122.86 | 539.40 | 0.4804 | 2.08 |
| Worst-3 (random×960000, 1 row/tx) | 1,078 | 1075.74 | 512.98 | 0.4769 | 2.10 |
| pgbench (TPC-B-like) | 550,539 | 1661.06 | 190.29 | 0.1146 | 8.73 |
Итог и рекомендации по использованию коэффициента
-
Рекомендуемый подход — по выше описанной методике измерьте коэффициент на своем стенде/прод-профиле.
-
Если нет возможности провести тестирование на своем стенде:
- Практически безопасная стандартная рекомендация для расчета диска Kafka под retention, опираясь на worst-cases — (K/W=0.48) (W/K=2.08).
- Самостоятельно оцените сжимаемость и размер транзакций и, опираясь на таблицу тестирования, подберите коэффициент.
-
Для системных топиков (
topic-error,topic-conflict-tx) — заложите размер KAFKADATA 100 МБ на каждый топик.
Соотношение размера выгружаемых данных к объему данных в Kafka
Цель
Получить cоотношение размера выгружаемых данных к объему данных в Kafka.
Результаты тестирования
По результатам тестирования ориентировочное соотношение размера выгружаемых данных к объему, занимаемому ими в каталоге /KAFKADATA, составляет:
pg_table_size/KAFKADATA ≈ 2.1
Указанное соотношение получено для случая, когда replication factor = 1.
Это означает, что при выгрузке INIT объем данных, занимаемых в Kafka, может отличаться от исходного объема таблиц в PostgreSQL и должен учитываться при расчете требований к дисковому пространству.
Для replication factor = N суммарный объем данных, занимаемый в Kafka-кластере, можно оценить по формуле:
KAFKADATA_total ≈ (pg_table_size / 2.1) × N
При этом эквивалентное соотношение примет вид:
pg_table_size / KAFKADATA_total ≈ 2.1 / N
где:
KAFKADATA_total — суммарный объем данных по всем брокерам Kafka;N — значение replication factor.
Итог и рекомендации по использованию коэффициента
Объем данных в Kafka при выгрузке INIT может отличаться от исходного объема таблиц в PostgreSQL и должен учитываться при расчете требований к дисковому пространству.