Архитектурные отличия OrioleDB
В отличие от стандартного механизма хранения Heap, OrioleDB реализует иную архитектуру организации данных, затрагивающую способы физического хранения строк, управления версиями данных, журналирования, работы с оперативной памятью и формирования контрольных точек.
Индексно-ориентированные таблицы
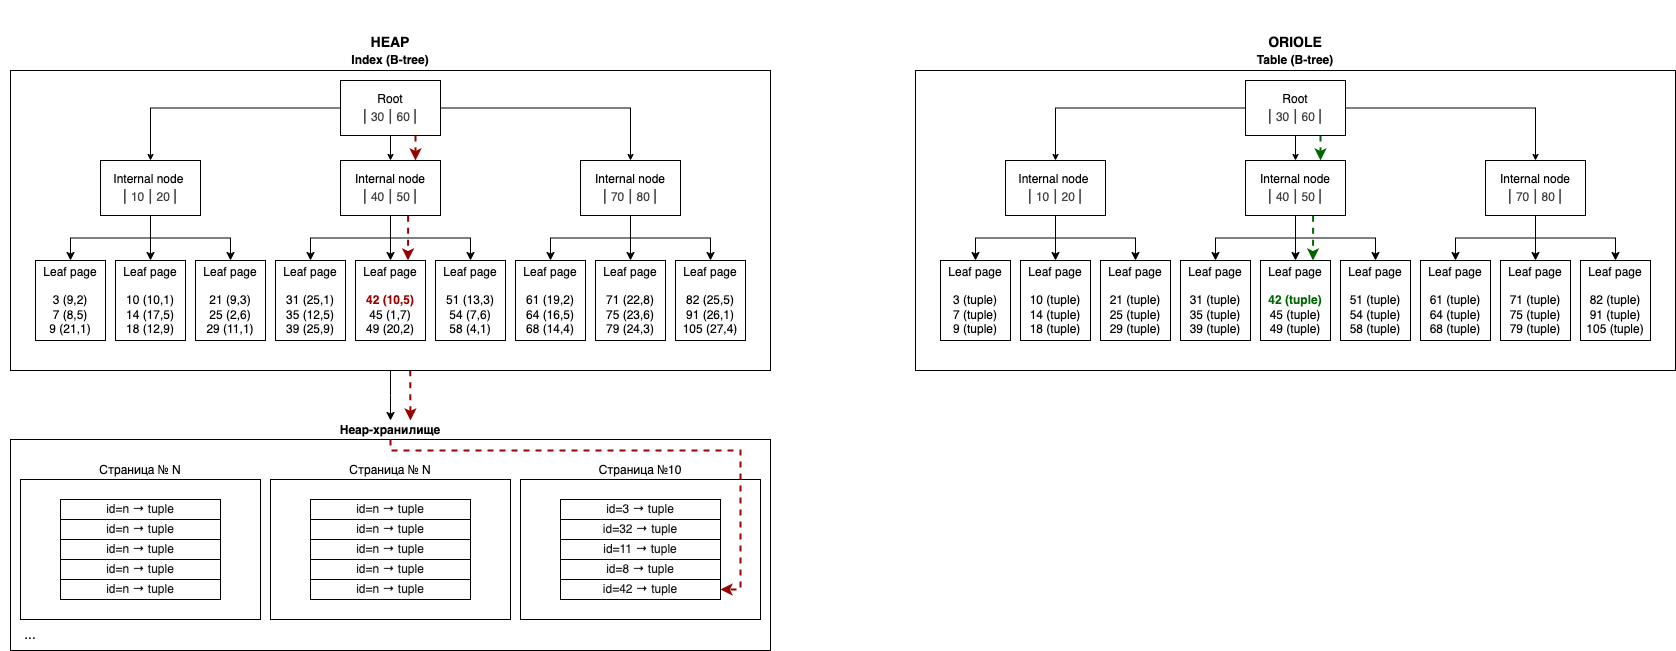
В архитектуре OrioleDB данные организованы в виде индексно-ориентированных таблиц, где базовая структура хранения представляет собой B-дерево. В этой модели само дерево одновременно выполняет функции физического хранилища данных, первичного индекса и таблицы, устраняя необходимость в традиционной структуре Heap.
Внутренние узлы дерева — корневой и промежуточные страницы — содержат исключительно ключи и указатели на дочерние ветви для маршрутизации поиска. Полные версии строк физически располагаются только в листовых страницах, которые упорядочены по значению ключа первичного индекса.
На схеме ниже представлен пример поиска строки по первичному ключу, иллюстрирующий различие в организации хранения данных в Heap и OrioleDB, при запросе SELECT * FROM table1 where id=42;:
Общий принцип организации страниц
OrioleDB использует многоуровневую организацию хранения данных, при которой страницы дополнительно разделяются на независимые блоки – чанки (chunks), являющиеся единицами внутреннего управления памятью. В отличие от Heap, где изменения традиционно привязаны к странице, использование чанков позволяет локализовать операции чтения и записи на уровне отдельных блоков данных, уменьшая объем копируемой информации при модификации, и повышая эффективность механизмов хранения. Подробнее в документации OrioleDB.
UNDO-лог
Страницы B-деревьев в OrioleDB содержат только актуальные версии строк. Когда транзакция обновляет или удаляет строку, новая версия записывается на страницу, а информация о том, как вернуть состояние назад (предыдущее значение), помещается в журнал отмены (UNDO).
Прямые ссылки вместо buffer mapping
В OrioleDB страницы данных в оперативной памяти связываются с узлами индексной структуры посредством прямых указателей. Благодаря этому при запросе отсутствует необходимость выполнять поиск страницы в глобальной таблице соответствий буферов (buffer mapping) и использовать связанные с ней механизмы синхронизации. Если требуемая страница отсутствует в памяти, она считывается с диска в буферный пул, после чего соответствующий узел дерева обновляется, сохраняя прямую ссылку на загруженную страницу. Последующие обращения используют уже установленный указатель, минуя дополнительный этап поиска.
Copy-on-Write для контрольных точек
OrioleDB использует механизм Copy-on-Write при создании контрольных точек. При изменении данных страницы B-дерева не перезаписываются поверх существующих на диске, а записываются в новое свободное пространство хранилища. Одновременно создаются новые версии всех родительских узлов по пути от измененной страницы до корня дерева, тогда как предыдущая версия дерева остается неизменной. После завершения записи атомарно обновляется единственная корневая ссылка таблицы, которая начинает указывать на новую версию дерева.
Строчный WAL
Благодаря использованию индексно-организованных таблиц в OrioleDB механизм журналирования WAL реализован на уровне строк, а не блоков данных. В журнал предзаписи попадают логические изменения строк, включая значения первичного ключа и TOAST-данные при необходимости. Поскольку пользовательские данные физически хранятся непосредственно в листьях первичного В-дерева, то вторичные индексы могут быть восстановлены на основе изменений первичного ключа. В связи с этим изменения вторичных индексов не журналируются отдельно, что позволяет сократить объем записываемых данных.
Сжатие данных на уровне блоков
В OrioleDB становится возможным использование встроенной библиотеки ZSTD для сжатия данных на уровне блоков: перед сбросом на диск содержимое страницы целиком упаковывается, после чего результирующий поток байтов записывается в файл. В отличие от классического движка Heap, где каждая страница имеет фиксированный физический размер 8 КБ независимо от степени заполнения, OrioleDB записывает на диск уже сжатое содержимое страницы, размер которого определяется результатом сжатия.
Размещение в файловой системе
При создании отношения OrioleDB выполняется его регистрация в системных каталогах СУБД с назначением идентификатора relfilenode. На основании значения relfilenode в каталоге базы данных создается пустой файловый объект, который носит лишь служебный характер и обеспечивает совместимость с внутренними механизмами ядра СУБД. Данный файл остается пустым и не используется для хранения пользовательских данных OrioleDB.
Фактическое хранение данных отношения осуществляется в собственном файловом пространстве OrioleDB с использованием собственного формата хранения.
Особенности определения физического расположения файлов:
- Отношения с первичным ключом. При наличии первичного ключа данные таблицы OrioleDB физически размещаются в индексно-организованной структуре первичного ключа. В системном каталоге
pg_classсоздаются записи как для отношения, так и для индекса первичного ключа. Для каждого объекта также создается служебный файл в каталоге БД, который не используется для хранения пользовательских данных. При этом функцияpg_relation_filepath()для таблицы возвращает путь к файлу индекса первичного ключа в файловом пространстве OrioleDB. - Отношения без первичного ключа. При отсутствии первичного ключа OrioleDB автоматически создает индекс по системному столбцу
ctid, который используется в качестве основной структуры хранения данных. В системном каталогеpg_classсоздается запись отношения. Для объекта также создается служебный файл в каталоге БД, который не используется для хранения пользовательских данных. Для таких отношений функцияpg_relation_filepath()возвращает путь к файлу отношения в файловом пространстве OrioleDB. - TOAST-таблицы. Для TOAST-таблиц функция
pg_relation_filepath()возвращает путь к файлу основной таблицы в файловом пространстве OrioleDB.